
Prometheus 监控系统 v3.15.1:双平台单文件即开即用,自带时序数据库
监控自己的服务器和应用,听起来是个大工程:装数据库、配采集端、写面板,一套下来比业务本身还重。Prometheus 把这三件事压缩成一个可执行文件——拉起来就是一个带查询、图表、告警规则的完整监控系统,时序数据库内置,连配置文件都只需要十几行。它是云原生监控领域事实上的标准,Kubernetes 生态里几乎所有的组件都按它的格式暴露指标。
我拿到的是 3.15.1 版(2026 年 10 月 21 日构建,Go 1.27.3 编译),Windows 和 Linux 两份二进制都测了一遍。结论先说:Windows 版从进程拉起到网页可以访问约 2.2 秒,Linux 版(WSL2 实测)约 1.1 秒,零依赖、零安装,解压就能跑。如果你要的是带精美面板的开箱即用监控,它需要再配一个 Grafana;如果你要的是可靠的指标采集、存储和告警内核,它就是标准答案。
它是什么,和 Zabbix 差在哪
Prometheus 是一个时序数据库加指标采集器加告警引擎的三合一单体程序。它每隔一段时间去"拉"各个目标的指标接口(HTTP 拉模型),把数值存进内置的 TSDB,然后用一门叫 PromQL 的查询语言做聚合运算,再按规则触发告警。
和传统监控的区别在三处:
- 拉模型:不需要在被监控机器上装 agent 常驻推送,目标只要暴露一个 HTTP 指标接口就行。挂了反而更容易发现——拉不到就是 DOWN。
- 维度数据模型:每条指标带一组键值对标签,比如
up{job="prometheus", instance="localhost:9090"}。查的时候按标签切片聚合,不用提前定义表结构。 - PromQL:查询语言本身就是计算引擎。
sum(rate(http_errors_total[5m])) / sum(rate(http_requests_total[5m]))一句话算出 5 分钟错误率,不用导数据到别处再算。
它自己不画漂亮的大屏。官方界面能查、能画简单的图、能看目标健康度,但如果要给老板看的那种面板,标准做法是再叠一层 Grafana,数据源指向它就行。
我的测试环境
- Windows 侧:Windows 11 x64,干净目录,包内
windows/prometheus.exe(约 139MB)+ 默认配置 - Linux 侧:WSL2 Debian(内核 6.18),包内
linux/prometheus(约 138MB)+ 默认配置 - 版本确认方式:内置接口返回 version 3.15.1,revision bae3eced,构建日期 20261021
安装:Windows,解压即用
两步:
解压后在目录里执行
.\prometheus.exe --config.file=prometheus.yml
控制台会滚动打印启动日志。等 Server is ready to receive web requests 这一行出现就绪了,浏览器打开本机的 9090 端口。
默认配置只需要一个采集任务(抓它自己),十几行:
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]
scrape_interval 是采集周期,15 秒对绝大多数场景够用。要加新目标就在 scrape_configs 里追加 job_name,把目标的 9090 端口(或任何暴露 /metrics 的地址)填进 targets。
安装:Linux,同样一个文件
tar xzf prometheus-*.linux-amd64.tar.gz
cd prometheus-*
./prometheus --config.file=prometheus.yml
没有依赖、不需要 root(监听 9090 非特权端口)。生产上建议配一个 systemd 单元托管,把 --storage.tsdb.path 指到一块容量足够的盘(指标数据的保留默认 15 天,可加 --storage.tsdb.retention.time=30d 之类调整)。
包里同时给了 Windows 和 Linux 两份二进制加同一份配置文件,两边的用法完全一致,配置可以原样复制。
上手 5 步:从零到第一张图
- 启动主程序,打开本机的 9090 端口网页
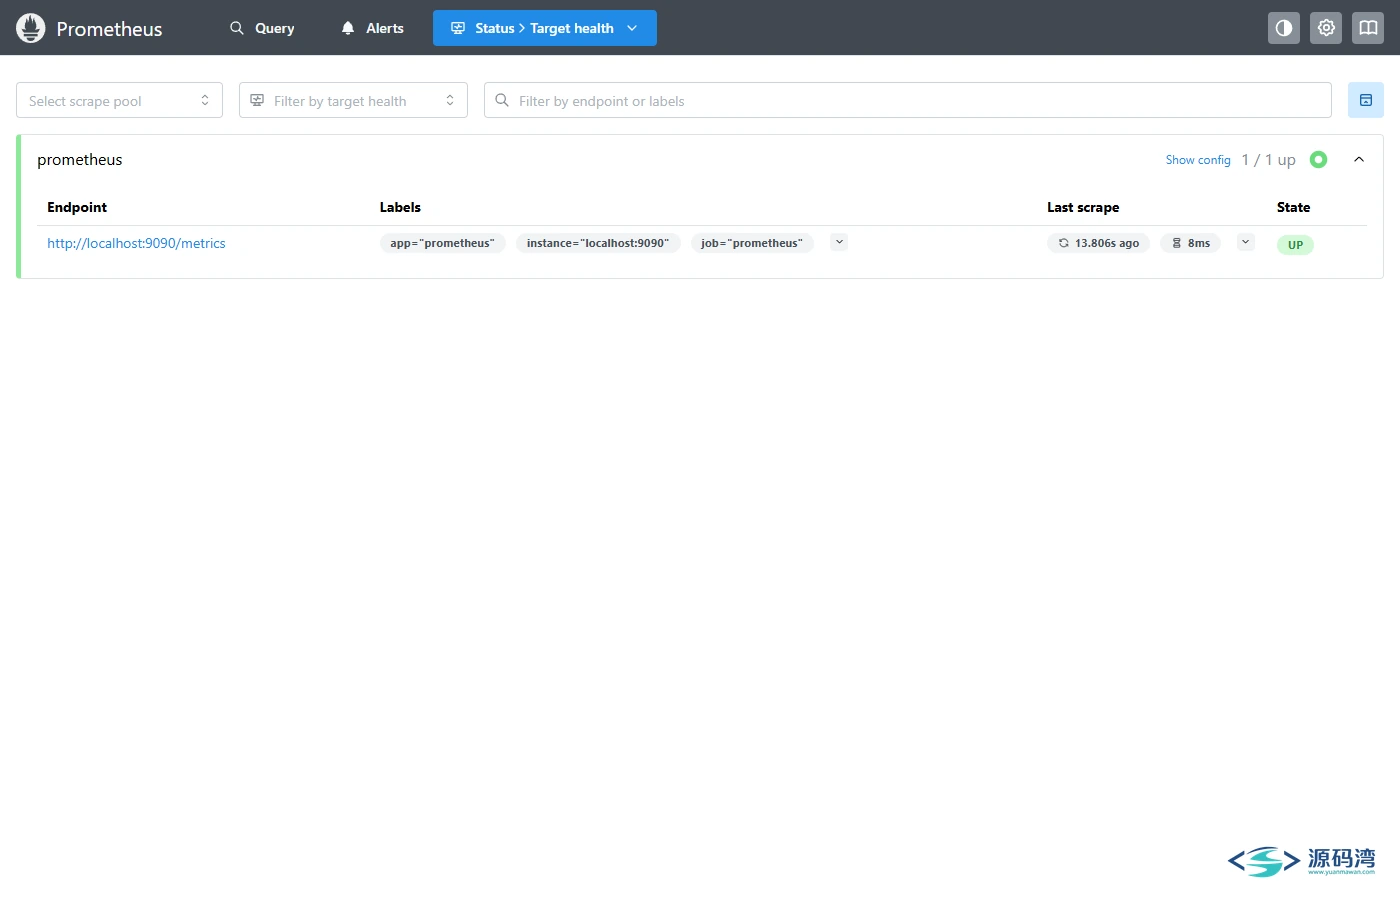
- Status > Target health:确认采集目标是绿色 UP
- 在查询框输入
up点 Execute:所有目标的存活状态一目了然(1 = 活着) - 输入
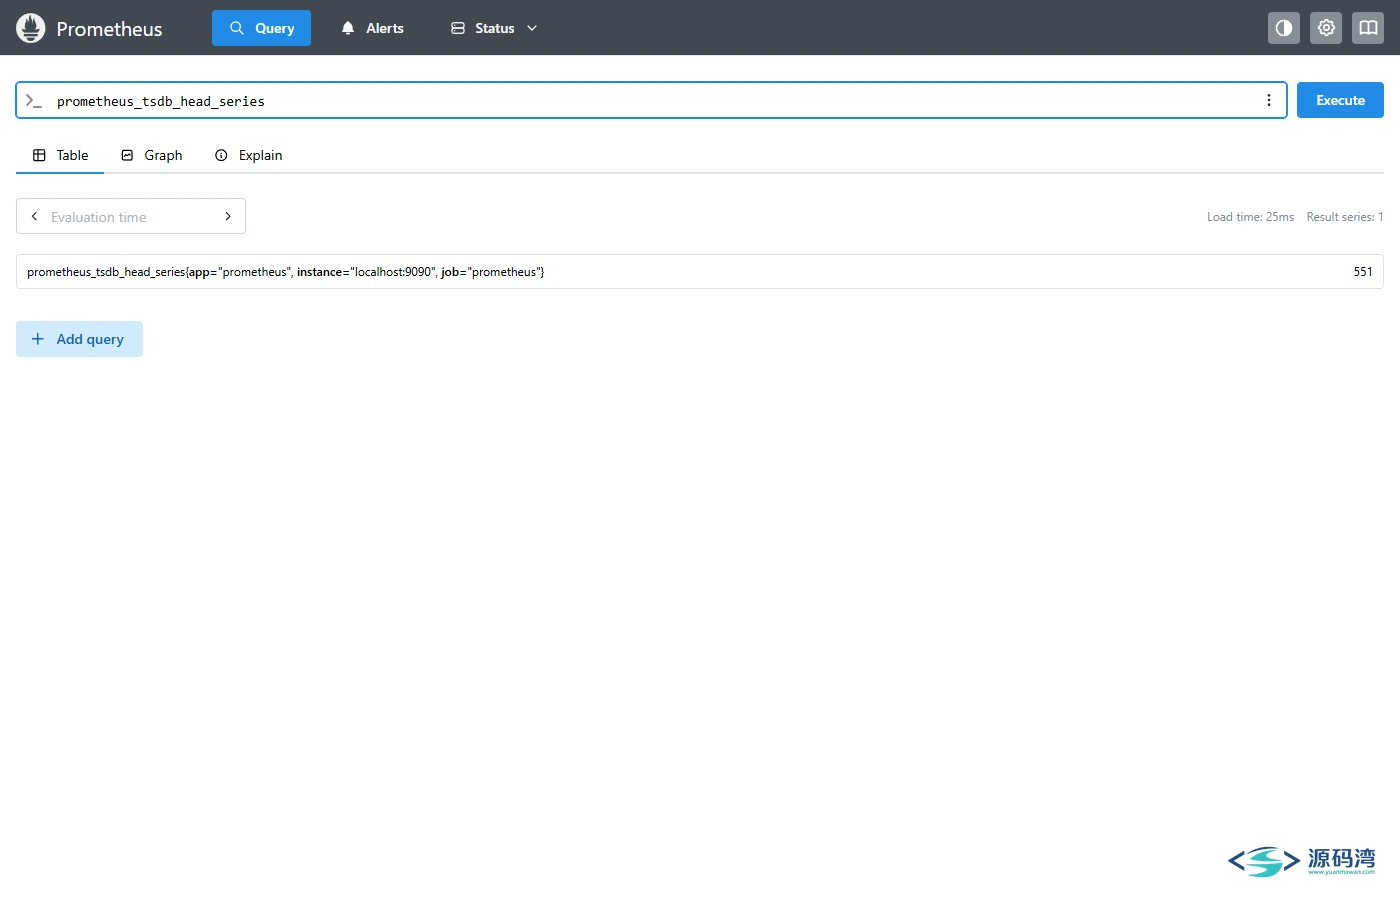
prometheus_tsdb_head_series切到 Graph 页:能看到自己已经画出了折线图 - 写一条告警规则文件,在配置里挂上
rule_files,Alerts 页就会出现待触发的规则
第 4 步是我实际截图验证过的:查询 prometheus_tsdb_head_series 返回 551 条活跃序列(刚启动 20 秒的自监控数据),Graph 页正常绘制。
实测数据
- Windows 启动到 /-/ready 返回 200:2168ms(干净目录、默认配置)
- Linux(WSL2 Debian)启动到就绪:1124ms
- Linux 首个网页请求:9.2ms 返回 200(页面 1752 字节)
- 配置加载总耗时:约 1.17 秒(含首个采集周期)
- 查询接口 /api/v1/query:200,返回标准 JSON
- 版本接口 /api/v1/status/buildinfo:确认 3.15.1 / Go 1.27.3
- 新目录 TSDB 初始占用:约 0.02MB,非常小
- 截图时 8 个页面全部 HTTP 200,无 JS 报错
一句话:这个体量的"单体监控系统",启动比很多静态博客生成器还快。
界面长什么样
查询页,输入 PromQL 直接出表格结果,切 Graph 就是折线图:
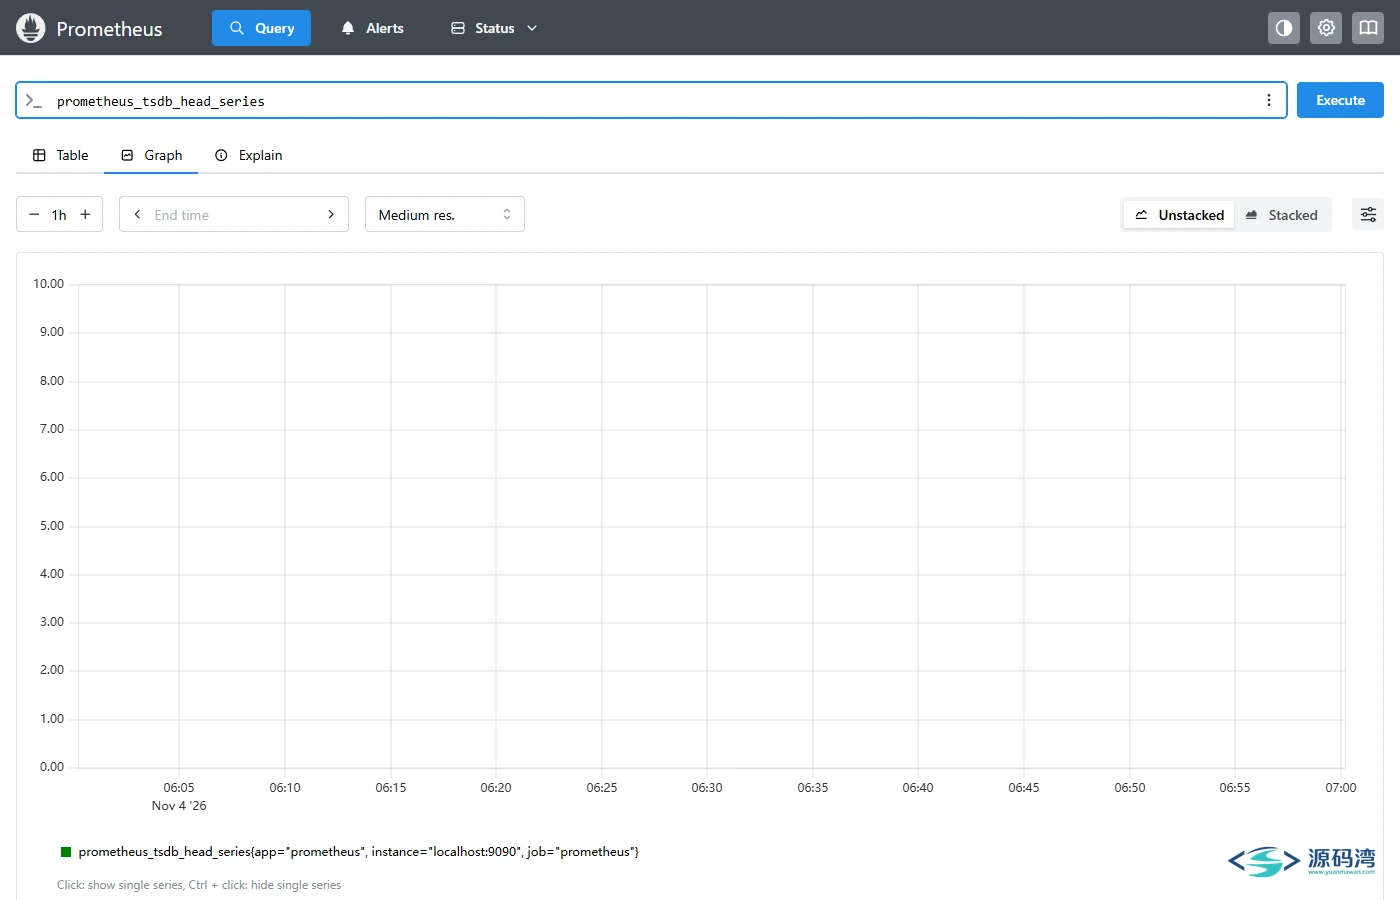
Graph 模式实时绘制指标折线:
Target health 页,绿色 UP 表示采集正常,这一页是排障第一站:
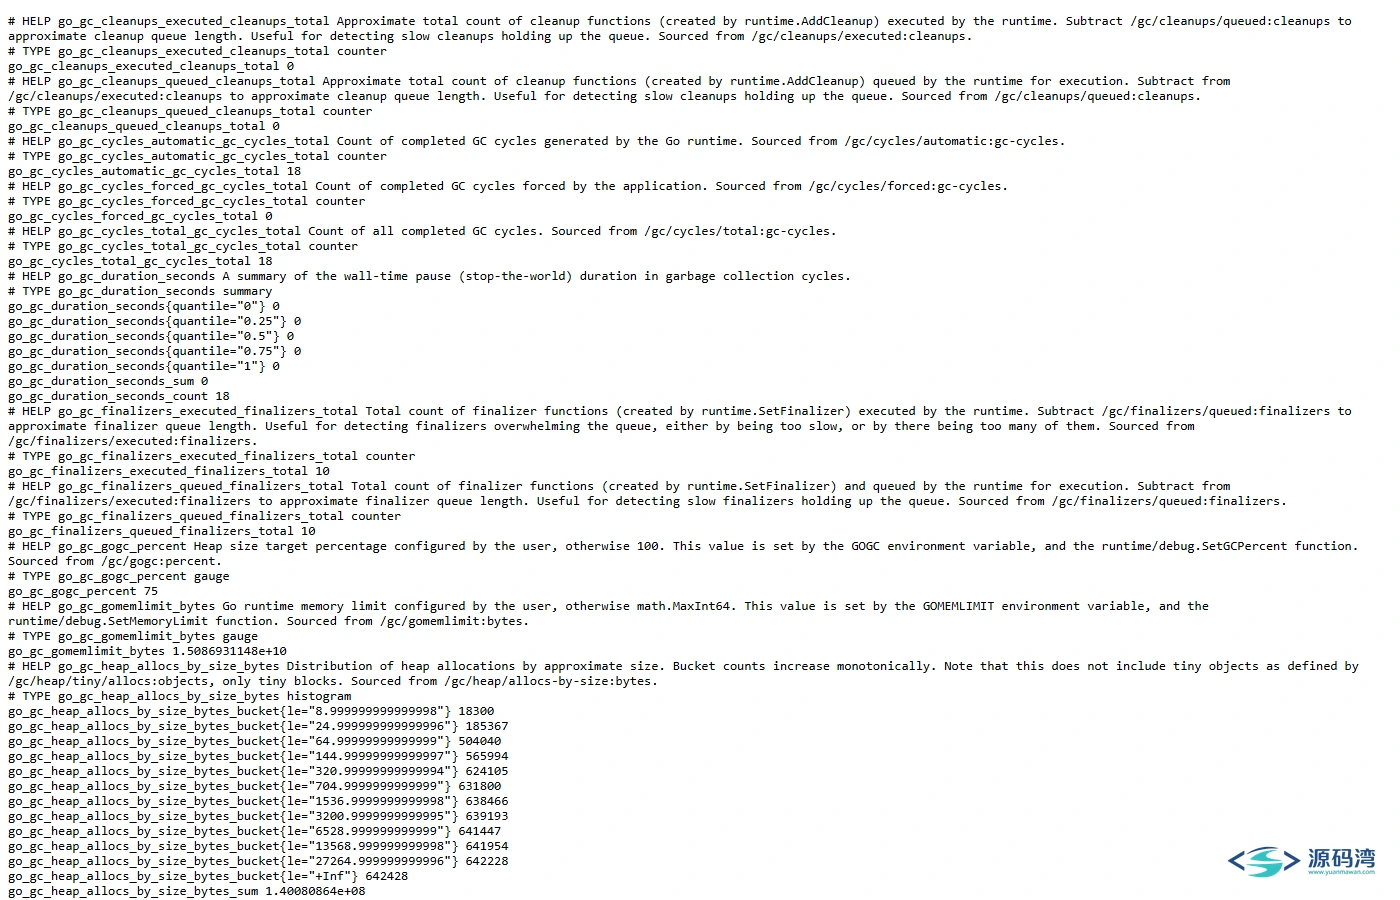
/metrics 原始指标端点,所有被采集的数据长这样(文本格式,人类可读):
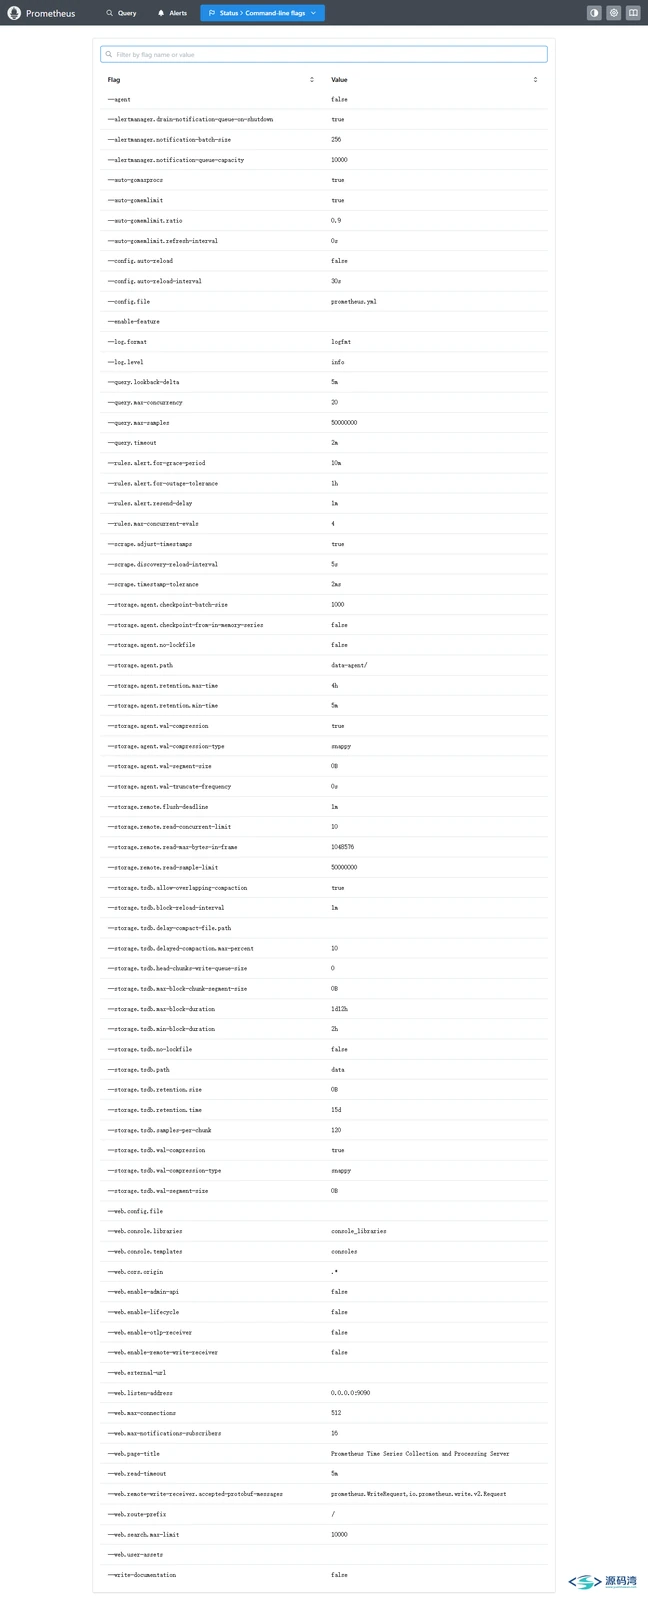
启动参数页,所有命令行开关一览:
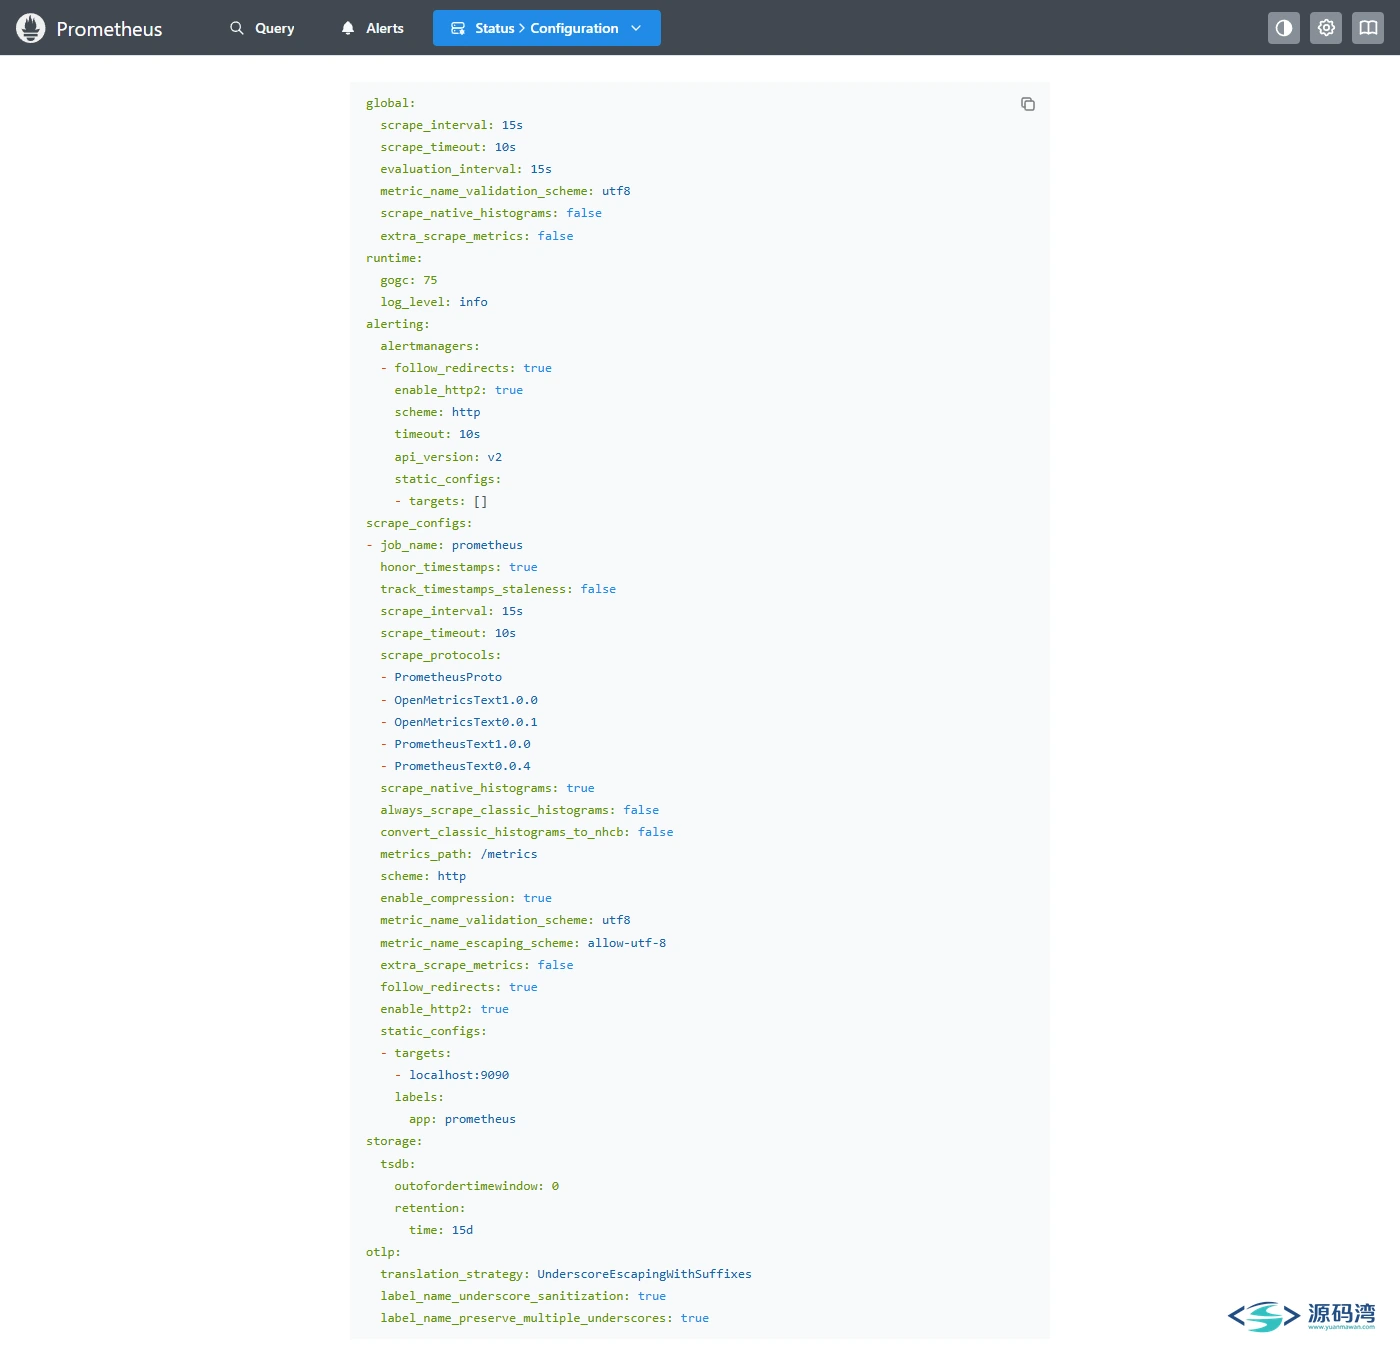
生效中的采集配置:
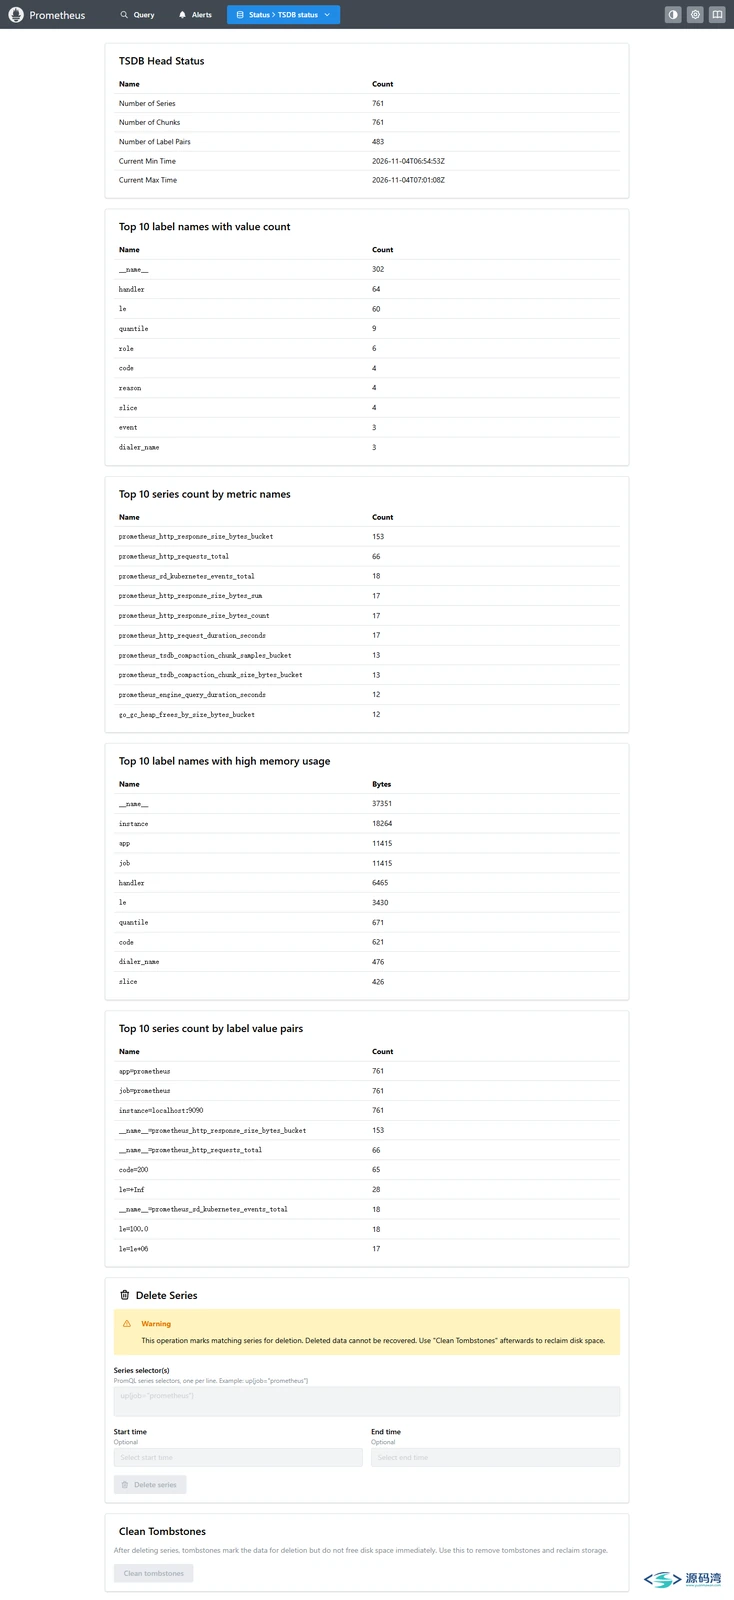
TSDB 存储状态,序列数、块大小、WAL 状态都在这:
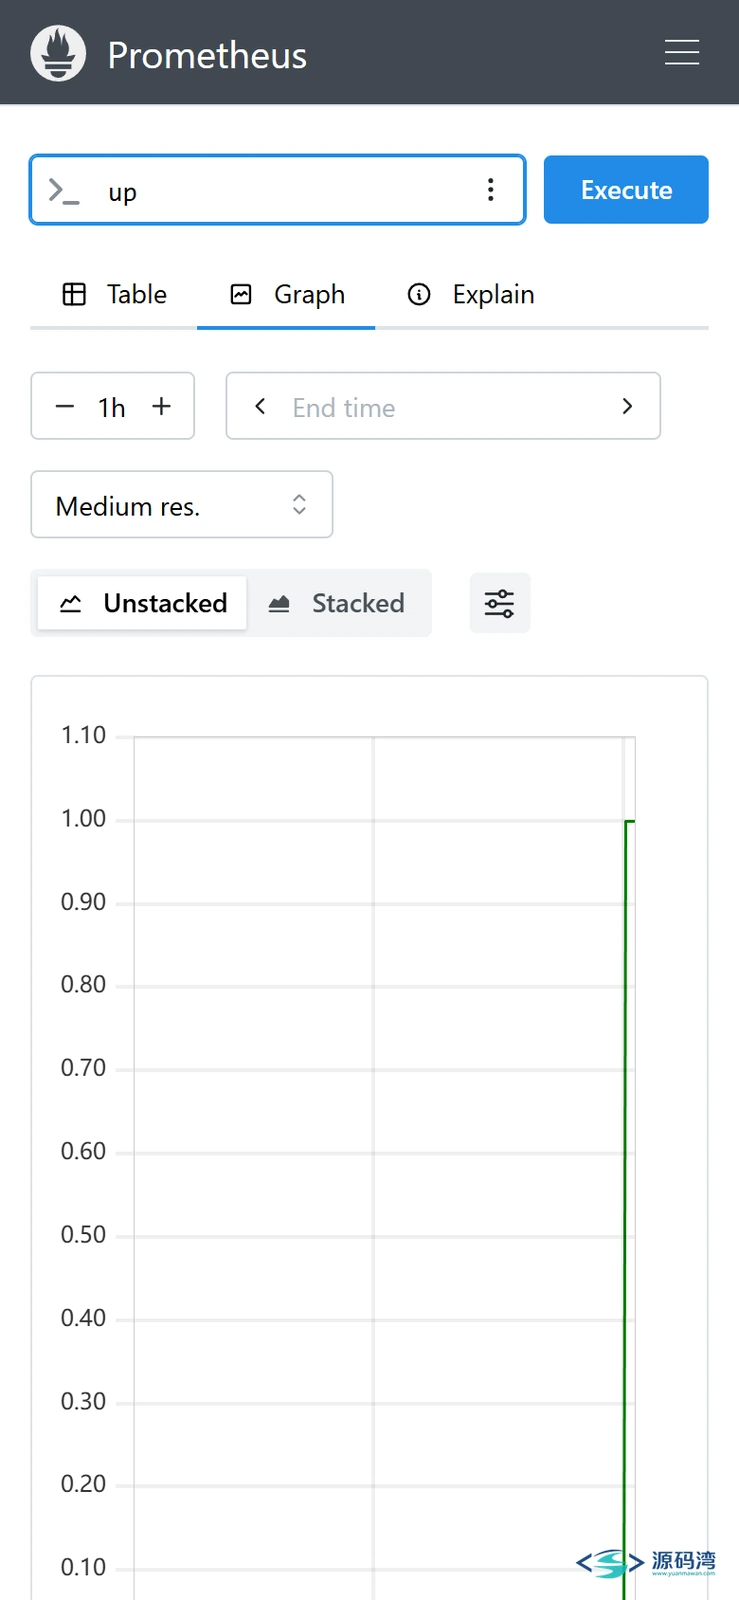
手机浏览器访问也正常布局:
一个真实的坑
我第一轮测试把服务监听在 19099 端口,结果 Target health 页显示采集目标 DOWN,报错原文:
Error scraping target: Get "http://localhost:9090/metrics": dial tcp [::1]:9090:
connectex: No connection could be made because the target machine actively refused it.
原因很直白:默认配置里写死了抓 localhost:9090,而我改了监听端口没改抓取目标。这类"目标 DOWN"在 Prometheus 里是常态而非故障——它把"拉不到"如实记录成 DOWN 状态而不是静默失败,这正是拉模型的好处。改回默认 9090 后立刻 1/1 up。
另一个值得知道的点:首次截图时查询页一度显示 "No data queried yet"。这不是 bug——页面加载后要等一个采集周期(默认 15 秒)数据才会进来。部署完别急着下结论,等 15~30 秒再刷新。
上线 / 部署建议
- systemd 托管:
ExecStart=/opt/prometheus/prometheus --config.file=/etc/prometheus/prometheus.yml --storage.tsdb.path=/var/lib/prometheus - 数据盘单独划分,TSDB 增长速度和序列数、采集周期相关,默认保留 15 天
- 被监控端要么暴露 /metrics,要么部署对应的 exporter(node_exporter 管主机、mysqld_exporter 管数据库,生态里有几十种现成的)
- 告警触发后 Prometheus 本身不发邮件不发消息,要配 Alertmanager(同样是官方的单文件程序)做去重、分组和路由
- 大屏需求配 Grafana,数据源选 Prometheus,一填地址就通
这几类人适合,这几类不适合
适合:
- 有几台到几百台服务器、想自己掌控监控数据的运维和后端
- 在 Kubernetes 上跑业务——生态默认指标格式就是它的
- 想给自研应用加指标埋点的开发,SDK 覆盖 Go/Java/Python/Node 等
- 想要一个不依赖云厂商的纯本地方案的人
不适合:
- 想要开箱即用漂亮大屏且完全不想动手的——先装 Grafana 再说
- 以日志为主的场景——日志聚合请用 Loki 或 ELK,指标监控才是它的地盘
- 需要精确计费类数据(一分钱都不能差)的场景——它面向监控,数据有合理精度取舍
常见问题
{collapse-item label="数据会存多久?占多大空间?"}A:默认保留 15 天,可用启动参数调整。空间取决于序列数量,自监控场景启动 20 秒只有 551 条序列,普通规模(几千条序列)一天几百 MB 以内。{/collapse-item}
{collapse-item label="一定要配 Grafana 吗?"}A:不必须。自带界面够查数、画图、看目标状态。要给非技术人员看大屏,再加 Grafana。{/collapse-item}
{collapse-item label="告警怎么发到手机?"}A:Prometheus 只负责算规则,通知走 Alertmanager,支持邮件、webhook,配合企业微信/钉钉/飞书的 webhook 机器人即可。{/collapse-item}
{collapse-item label="agent 要装在被监控机上吗?"}A:不需要常驻推送 agent。目标暴露 /metrics 接口即可;主机指标用 node_exporter(很轻,官方单文件)。{/collapse-item}
{collapse-item label="重启会丢数据吗?"}A:不会。TSDB 有 WAL(预写日志),非正常掉电后重启会回放恢复,实测启动日志里 wal_replay_duration 毫秒级完成。{/collapse-item}
源码获取
打开卡片后建议先转存到自己网盘再下载,避免分享失效。