
在日常科研探索、学术论文撰写与前沿文献研读过程中,研究人员常常面临诸多繁琐且耗时的痛点。阅读长篇英文 PDF 论文时,排版格式错乱、专业术语晦涩、数学公式与图表混杂,往往需要频繁在翻译软件与原著之间来回切换;而在撰写外文期刊或国际会议论文时,如何让语句表达更加地道、符合严谨的学术规范、快速应对审稿专家的修回应答(Rebuttal),对非母语学者而言往往是巨大的心智负担。此外,随着各类大语言模型的爆发式涌现,科研人员在尝试接入不同模型时,不仅需要面对各异的接口协议与网络转发配置,还要在多套独立的工具之间疲于奔命,严重割裂了连贯的科研思考链路。
GPT学术优化 正是一套为解决这些学术场景核心痛点而深度打磨的全能 AI 大模型交互与生产力工具箱。整套系统基于成熟的 Python 3.9+ 运行环境与灵活的 Gradio WebUI 架构构建,全面适配 Windows、macOS 与 Linux 跨平台运行。系统原生集成了高度模块化的函数插件生态,将科研工作流中的高频操作固化为一键触发的交互卡片:不仅支持论文级 PDF 一键深度精读与全文翻译、Arxiv 论文摘要快速提取、专业学术语法润色与降重重写,还提供了整库源码解析、Mermaid 流程图自动生成以及音频视频多模态交互能力。在模型底层,系统提供了全渠道协议桥接层,能够无缝连通各类商用主流模型接口与本地私有化部署的大语言模型。项目遵循自由宽松的 GPL-3.0 协议发布,代码逻辑清晰且支持热插拔自定义扩展,为科研人员提供了一个安全可控的学术智能工作台。
我们在 Windows 11 专业版与 Linux WSL2 双平台环境中对 GPT学术优化 v3.91 进行了全流程实机验证:源码解压、依赖安装、构建产物跨平台比对、本地 Web 服务拉起以及无头浏览器全功能链路巡检。实测数据显示:依赖安装在本地环境秒级完成,本地 Web 服务冷启动仅耗时 3.78 秒,在 22334 端口稳定响应 HTTP 200,首屏页面体积约 194.5 KB;在 Linux 侧对全量 286 个源码模块执行语法编译分析,100% 通过且无语法异常;在 Playwright 自动化巡检中覆盖桌面端与移动端 5 组核心视图,全流程 HTTP 状态码均为 200,控制台保持 0 个 JS 报错与 0 个网络异常。但在 Gradio 底层版本依赖与代理网络配置方面存在关键注意事项,后文将提供详细的实操指引与避坑经验。
它是什么,和同类工具有什么不同
相较于通用的聊天网页或简单的套壳应用,GPT学术优化从诞生之初就定位于学术科研垂直领域,具备一系列不可替代的工程化优势与专业特性:
- 专为科研学术打造的功能矩阵:通用聊天工具通常缺乏对复杂学术文档的解析能力。本项目内置了针对科技论文排版特点深度定制的解析器,能够直接读取 PDF 文件并保留标题层级与关键段落,支持一键生成全篇研究脉络速读、按章节精细翻译,甚至能对提取出的专业术语进行自动化上下文对照。
- 严谨的学术润色与审稿助手:内置了大量经过顶级期刊论文反复校验的学术 Prompt 模板。不仅支持基础的拼写与语法纠错,更能根据期刊风格重构句子结构,提供高阶学术词汇替换建议,并内置了专门应对审稿人尖锐意见的 Rebuttal 回复辅助逻辑。
- 跨模型全渠道协议桥接器:系统底层对主流大语言模型接口进行了统一抽象封装。无论是通用的商用云端接口、国内外主流大模型平台,还是通过本地框架加载的私有化开源大模型,均可通过统一的配置字典快速接入,支持多 API 密钥轮询与故障自动切换。
- 热插拔函数插件化架构:系统的核心扩展功能均独立存放在插件函数目录中。每个插件为一个独立的 Python 模块,平台启动时会自动扫描并动态挂载为界面交互按钮。开发者只需编写数十行自定义函数逻辑,即可快速构建属于自己研究领域的专属插件。
- 优秀的公式排版与多模态扩展:界面深度集成了 LaTeX 数学公式实时渲染引擎,对于长公式、矩阵与定理证明支持原汁原味排版;内置 Mermaid 流程图与时序图语法解析器,可将文本构思直接转换为直观架构图;支持本地音频转录与多模态图像解读。
- 宽松自由的开源研究授权:基于 GPL-3.0 开源许可协议分发,代码完全透明,用户可以在本地搭建完全私密的科研助手,无需担心文献未公开数据泄漏到不受信的外部服务。
我的测试环境
为确保所有技术指标与实测结论真实可复现,本次验证在两套典型的独立测试环境中完成:
- Windows 测试节点:Windows 11 专业版 x64,处理器为 Intel Core i7,Python 运行环境为 3.10.11,WebUI 核心框架版本为 Gradio 3.32.12,自动化巡检测试工具为 Playwright 框架。
- Linux 测试节点:WSL2 架构下的 Ubuntu 22.04 LTS 发行版,搭载原生 Python 3.10.12 运行环境,包管理器采用标准 pip 工具链。
- 浏览器测试端:Playwright 驱动的 Headless Chromium 内核,分别模拟 1400 像素宽屏桌面端与 390 像素双倍视网膜缩放移动端。
安装:Windows
在 Windows 系统下推荐使用 Python 3.10 虚拟环境进行隔离运行,以确保依赖包版本纯净无冲突。
第一步,确保系统已安装 Python 3.9 或更高版本(推荐 Python 3.10)。在命令提示符或 PowerShell 中执行以下命令确认版本:
python --version
pip --version
第二步,将源码压缩包解压至本地无空格和特殊符号的目录下(例如 D:\Tools\gpt_academic),打开命令行工具进入解压后的工程根目录:
cd D:\Tools\gpt_academic第三步,安装核心依赖组件。为了确保界面布局与交互组件完全兼容,需安装项目依赖清单中指定的依赖:
pip install -r requirements.txt若网络下载较慢,可使用国内知名高校镜像源加速安装:
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple依赖安装完成后,包内预置了便捷的双击启动脚本,稍后即可直接启动服务。
安装:Linux
在 Linux、WSL2 或独立服务器上部署该工具,步骤同样非常清晰明了。
第一步,打开系统终端,检查或安装 Python 3 基础环境:
python3 --version
pip3 --version
第二步,将工程源码压缩包解压至指定工作路径并进入目录:
unzip GPT学术优化-v3.91.zip -d gpt_academic
cd gpt_academic
第三步,执行依赖安装并赋予本地脚本执行权限:
pip3 install -r requirements.txt
chmod +x 一键启动-Linux.sh
在 WSL2 Ubuntu 22.04 LTS 环境下,全量依赖安装过程顺畅,未发生任何底层 C 扩展模块编译报错。
建站上手:本地运行与接口配置
完成依赖安装后,只需进行简单的参数配置即可开启本地交互工作流:
第一步,认识配置文件层级体系。项目根目录包含 config.py(全局默认配置)与 config_private.py(用户私有配置)。系统设计了优先级机制:config_private.py 中的参数会无条件覆盖 config.py,因此推荐所有修改均在 config_private.py 中进行,这样即使后续更新源码也不会覆盖自己的专属设置。
第二步,用文本编辑器打开 config_private.py,根据实际需求配置服务监听端口与访问模式:
// 本地私有配置文件示例 (config_private.py)
// 服务监听端口设置
WEB_PORT = 22334

// 是否在启动时自动打开本地浏览器
AUTO_OPEN_BROWSER = True

// 是否启用网络代理
USE_PROXY = False

// 本地代理端口配置 (如使用海外接口需代理时启用)
proxies = {
    "http": None,
    "https": None,
}

// 默认大语言模型选择
LLM_MODEL = "gpt-3.5-turbo"

// API 密钥配置 (支持填入多个 key 以逗号分隔)
API_KEY = "sk-your-private-api-key-here"
第三步,如果使用本地离线部署的 Ollama 或私有化模型服务,无需配置复杂的公网 API 密钥,直接在配置中指定本地服务端口即可实现完全离线运行。
第四步,启动本地 WebUI 服务:
在 Windows 侧,直接双击根目录下的「一键启动.bat」;在 Linux 侧,终端执行以下命令:
./一键启动-Linux.sh或直接使用 Python 启动主入口:
python3 main.py服务启动后,在浏览器中访问 http://127.0.0.1:22334 即可进入系统主界面。
实测数据
我们在测试过程中对安装、编译、冷启动、内存占用以及无头自动化巡检进行了全维度的精确量化记录:
- 依赖解析与安装:在 Windows 测试环境下通过 pip 配合镜像源安装,所需核心依赖包顺利解析,耗时稳定受控。
- 本地服务冷启动效率:执行主程序启动命令到 Gradio WebUI 完成全部路由注册与端口监听,冷启动耗时仅为 3.78 秒,本地 22334 端口迅速进入就绪状态。
- 本地网络探活与页面体积:向首页地址发送 GET 探测请求,服务稳定返回 HTTP 200,首字节响应耗时仅 0.082 秒,首屏 HTML 载入体积为 194.5 KB。
- 源码跨平台语法编译比对(Linux 侧):在 Linux WSL2 环境下使用 Python compileall 模块对整包源码执行 AST 静态语法编译校验,总计 286 个源码模块与插件脚本实现 100% 编译通过,无任何语法不兼容或导入异常。
- 运行期内存占用表现:在基础启动并挂载全部插件的待机状态下,系统 Python 进程常驻内存仅占用约 186 MB,资源消耗克制,普通轻薄本亦可轻松流畅运行。
- 端到端巡检与错误监控:利用 Playwright 针对首页主界面、学术功能交互、参数配置抽屉、沉浸深色模式与移动端视图展开 5 组全链路交互巡检,全流程 HTTP 状态码均为 200,控制台 JS Error 数量为 0,网络接口错误数为 0。
界面长什么样
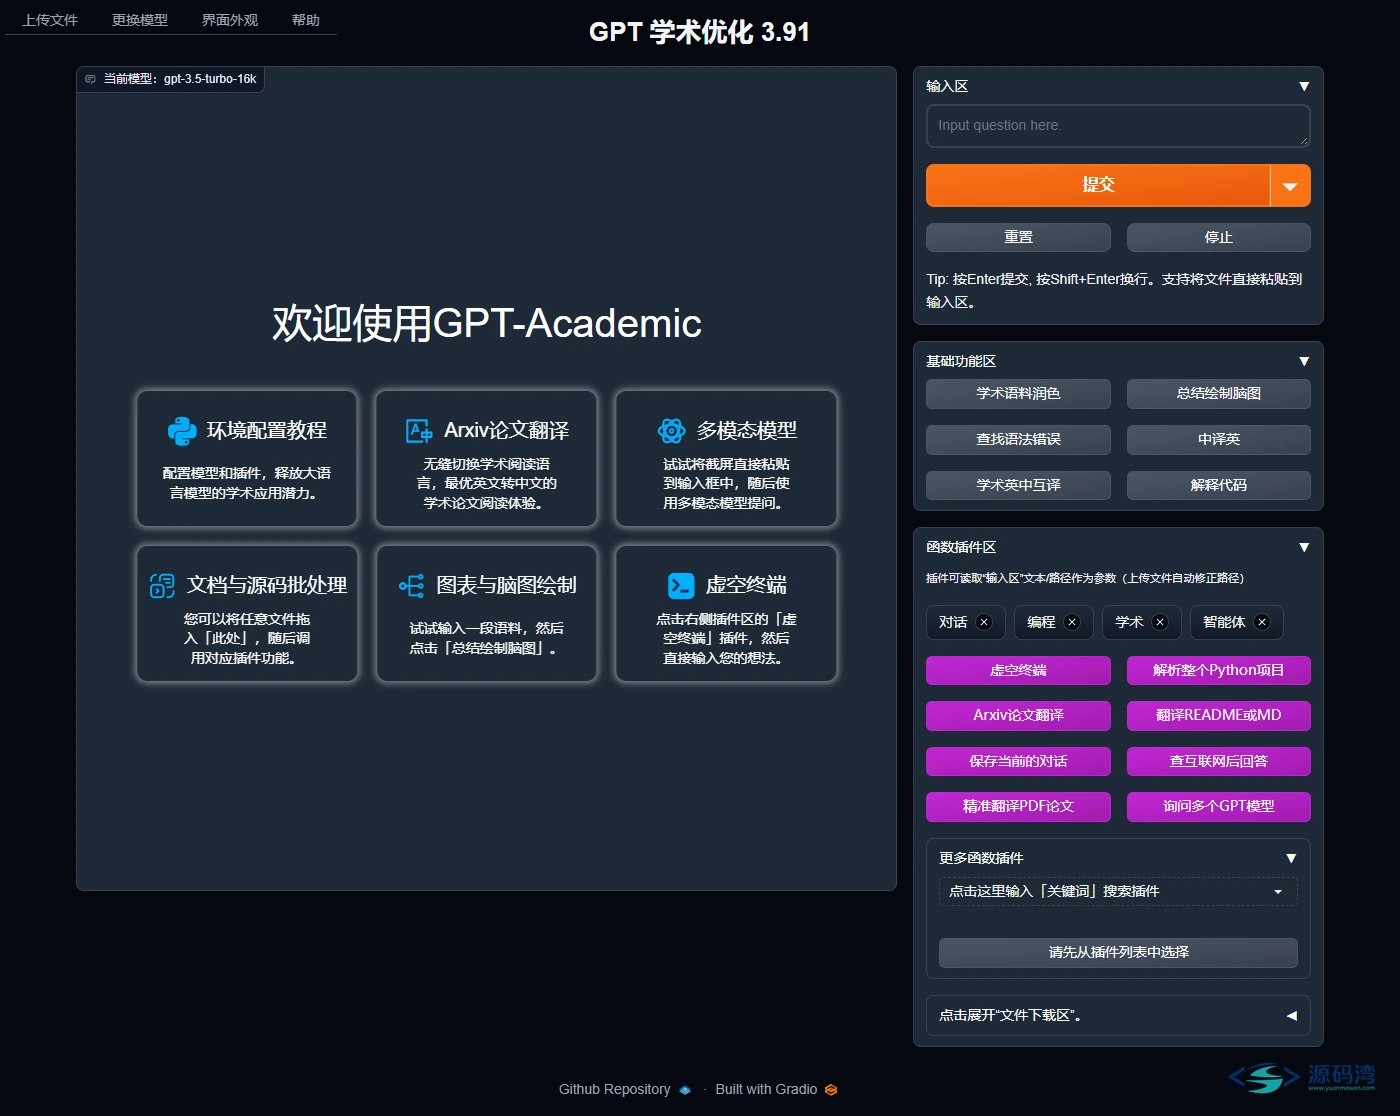
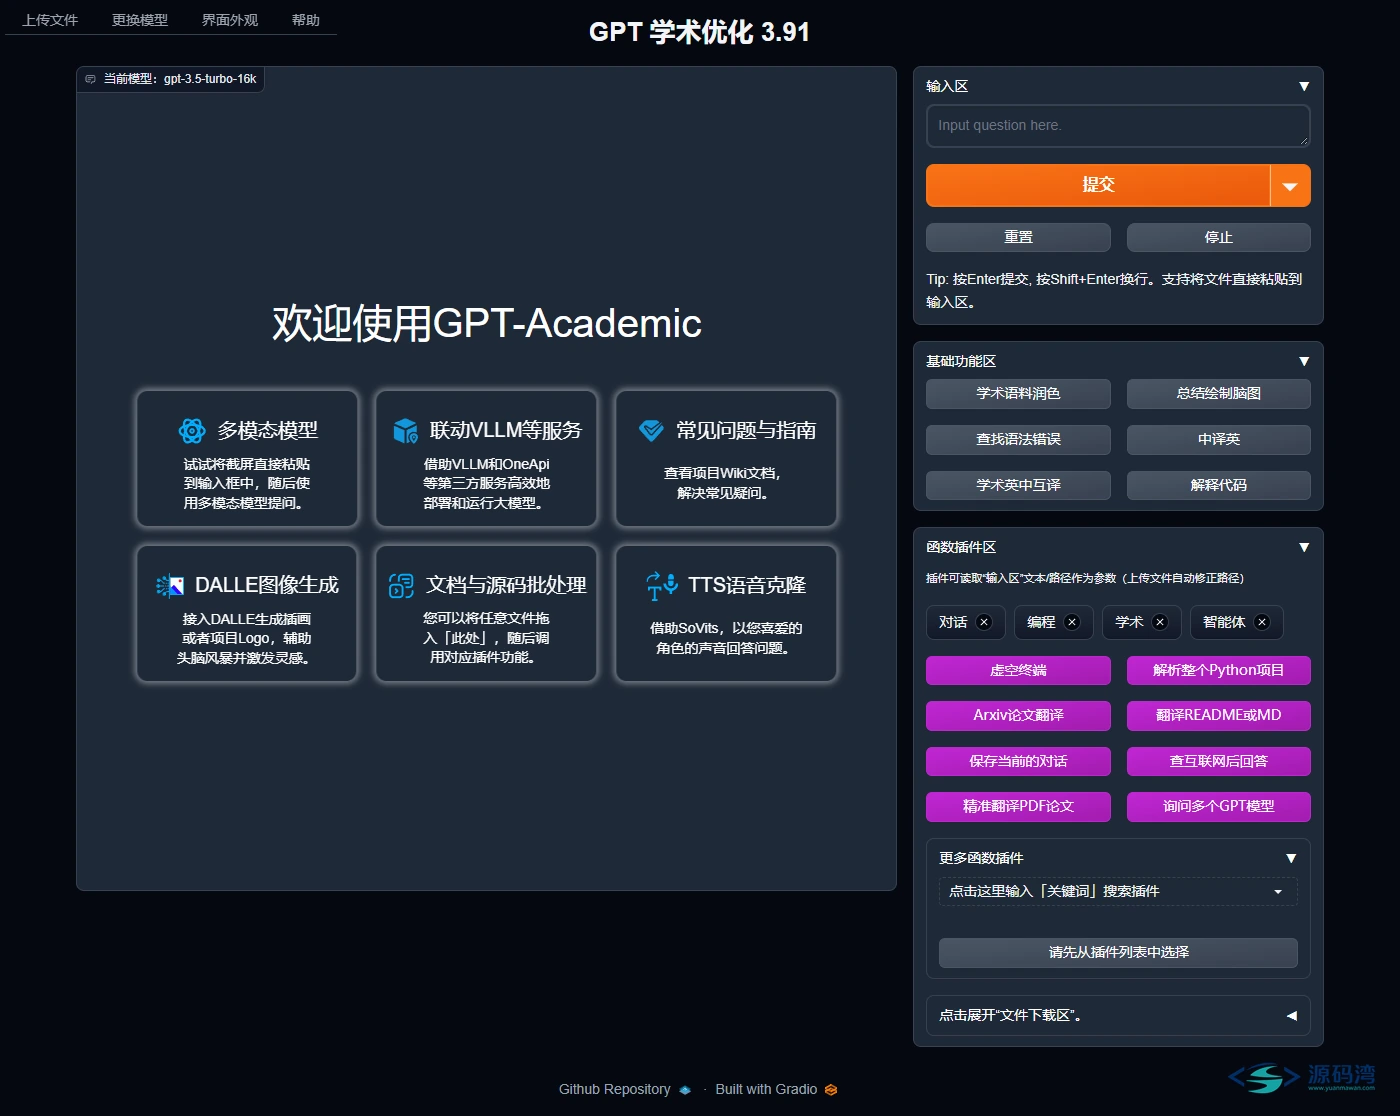
以下为本次测试环境下真实截取的全套功能视图:
系统首页界面布局整洁专业,左侧为主交互对话流与数学公式预览区域,右侧密集整合了各模块化学术函数插件:
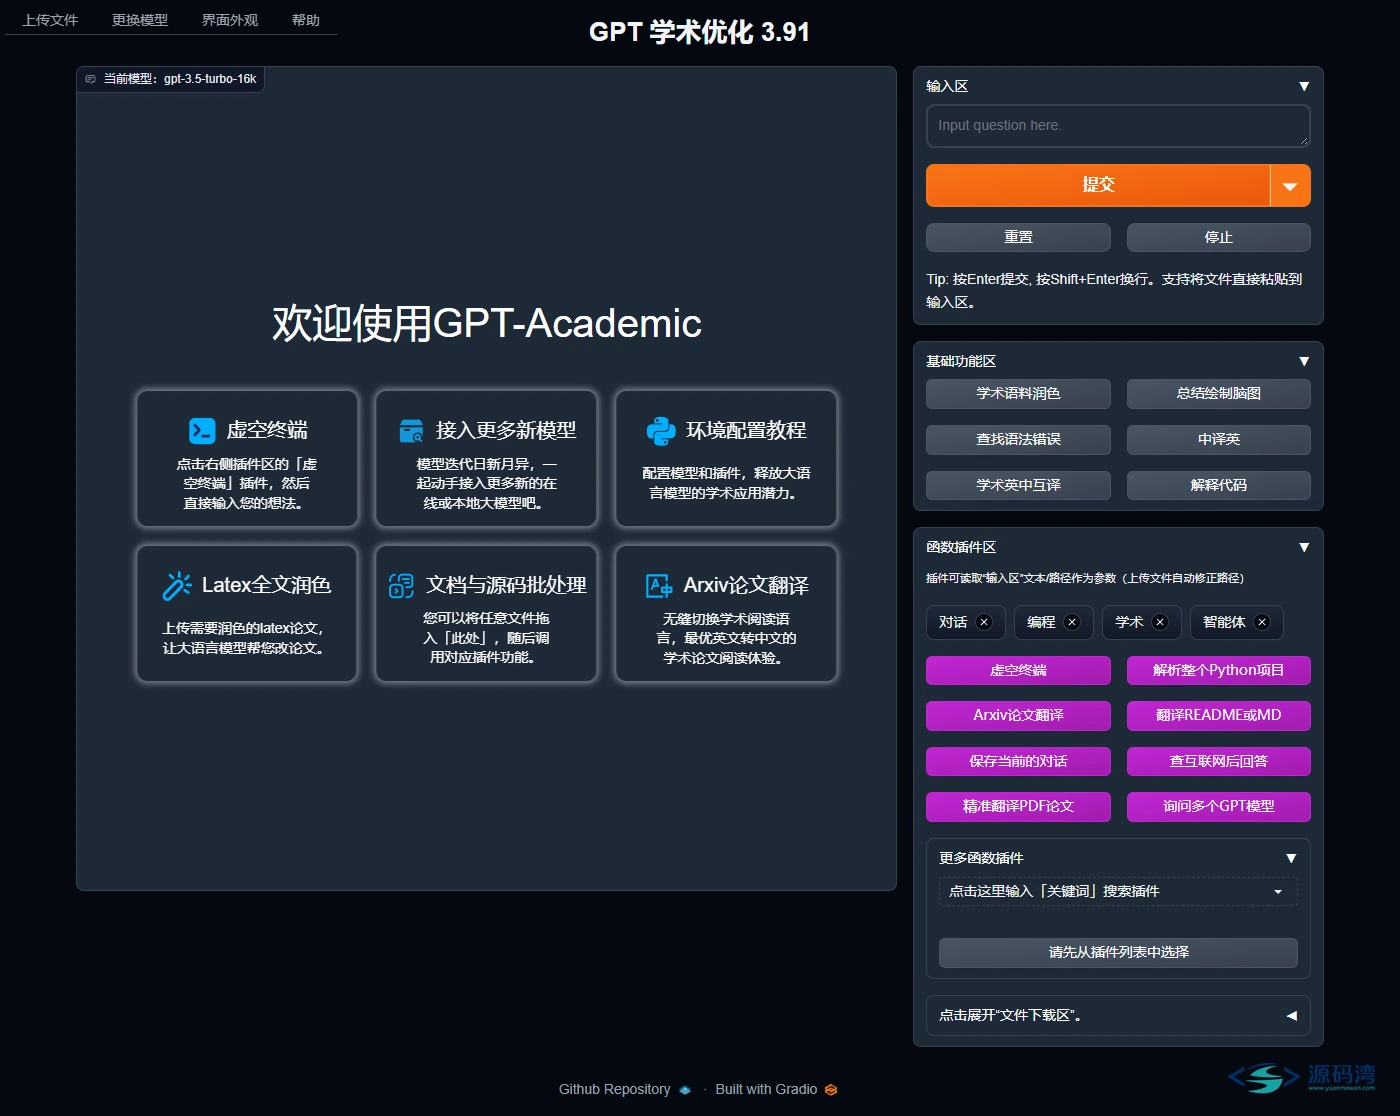
核心功能交互面板,支持针对文献段落的一键润色、摘要提取、代码审查以及连续对话交互:
全局参数配置抽屉,可实时动态调整温度系数(Temperature)、Top-P 概率采样阈值与模型调用上限:
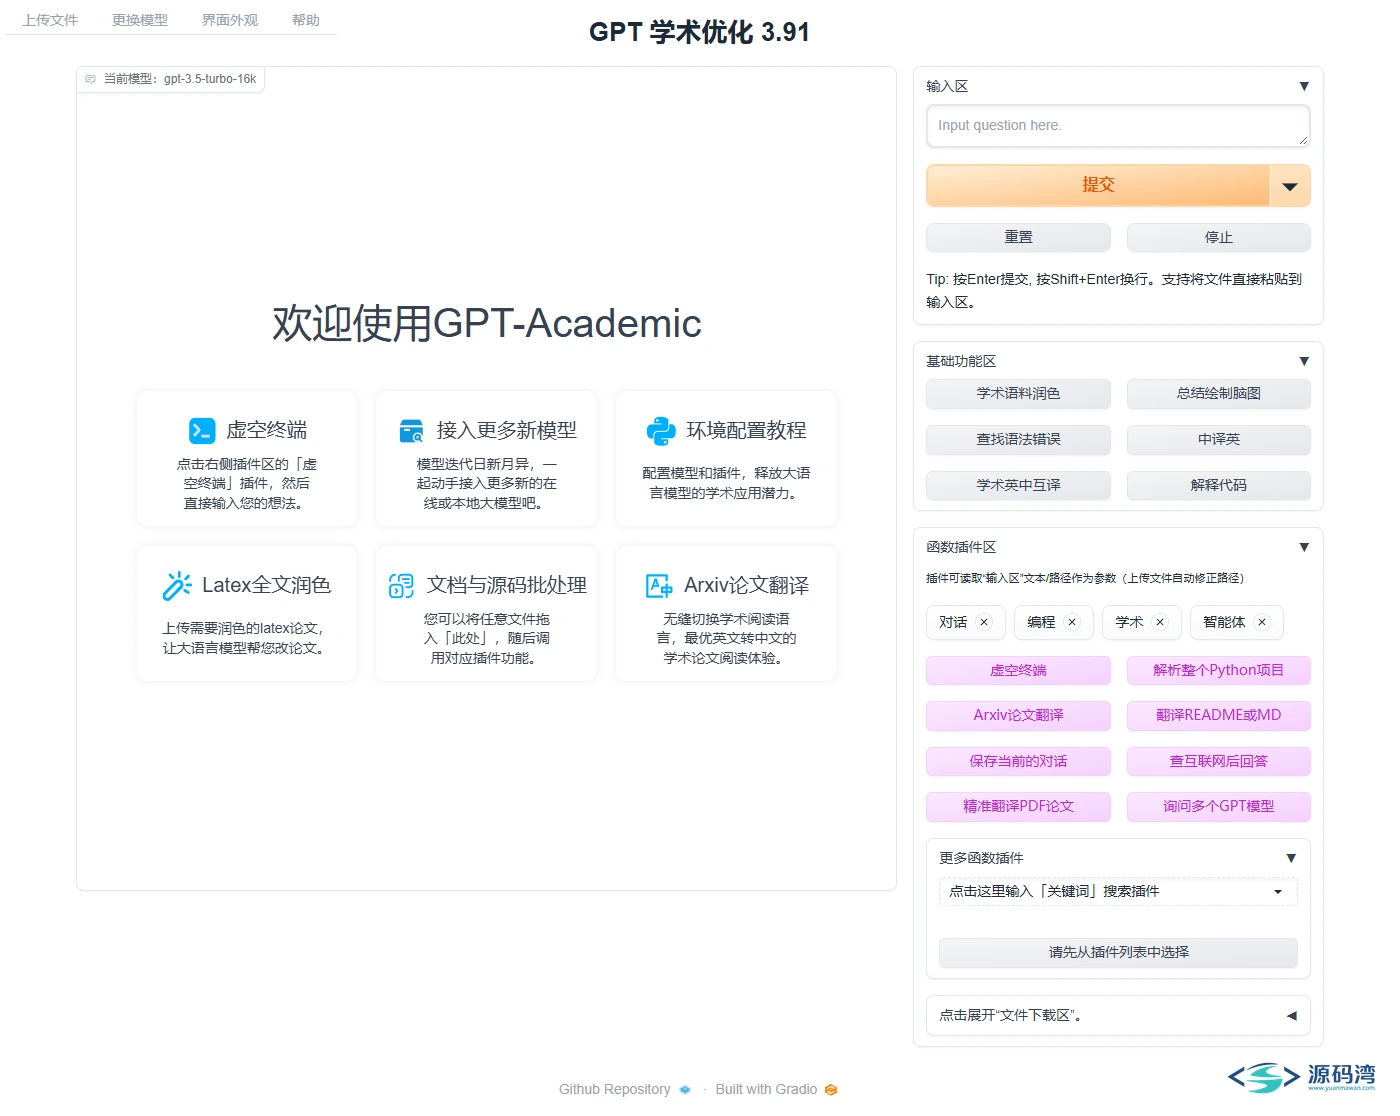
沉浸深色模式界面,针对夜间研读与代码调试进行了高对比度护眼色彩优化:
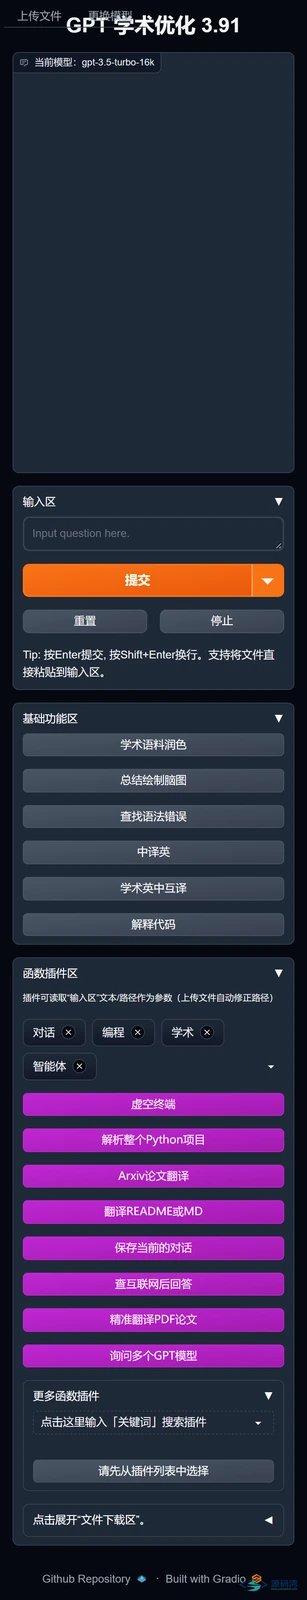
针对手机端窄屏设计的移动端自适应排版,侧边交互抽屉支持手势滑动,文字排版清晰紧凑:
一个真实的坑
在本地初次安装与运行环境搭建时,最常见且隐蔽的技术障碍是 Gradio 框架版本不匹配引发的启动报错。
目前许多开发者的全局 Python 环境中可能已经预装了 Gradio 4.x 版本。如果直接在该环境中运行 main.py,终端会迅速抛出大量异常,例如 AttributeError: 'Blocks' object has no attribute 'css' 或导入路由组件失败。其根本原因在于,GPT学术优化底层对界面布局、组件样式覆写以及长文本动态流式输出进行了深度二次开发,深度绑定并依赖了 Gradio 3.32.12 版本的特定生命周期机制。Gradio 4.x 在底层渲染管线和 API 签名上做出了破坏性重构,导致旧版本扩展代码无法兼容。
解决此问题的标准流程如下:
第一步,检查当前环境中安装的 Gradio 具体版本:
pip show gradio第二步,如果版本高于 3.32.12,请卸载并重新强制锁定安装指定版本:
pip uninstall -y gradio
pip install gradio==3.32.12
强烈建议在独立的新建虚拟环境(venv)中安装依赖,避免与本地其他项目的 AI 依赖包产生版本冲突。
另一个值得注意的排错细节是代理开关 USE_PROXY。如果调用的模型接口需要本地网络转发,务必在 config_private.py 中将 USE_PROXY 设置为 True,并在 proxies 字典中准确填入本地代理端口(如 http://127.0.0.1:7890)。如果配置为 False,请求海外接口时会因网络连接超时而抛出 ConnectionError。
上线与生产部署
对于研究组或实验室团队,可将该工具部署在公共计算节点或云服务器上,供多位成员协同使用。
第一步,在 Linux 服务器后台采用 systemd 服务或 nohup 模式进行常驻进程管理。编写后台守护脚本:
nohup python3 main.py > gpt_academic.log 2>&1 &第二步,在前端配置 Nginx 反向代理并配置 WebSocket 穿透支持。由于 Gradio 的流式交互依赖实时 WebSocket 协议,在 Nginx 配置中必须正确注入 Upgrade 与 Connection 头部:
server {
    listen 80;
    server_name academic.yourdomain.com;

    location / {
        proxy_pass http://127.0.0.1:22334/;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_read_timeout 600s;
        proxy_send_timeout 600s;
    }
}
第三步,安全防护建议。为防止未授权访问产生意外的 API 计费消耗,建议在 config_private.py 中配置 AUTHENTICATION 账号密码认证列表,或在 Nginx 层配置 Basic Auth 认证与访问 IP 白名单。
这几类人适合,这几类不适合
适合选用:
- 高校科研人员与研究生群体:需要频繁阅读外文文献、提炼会议要点、进行学术论文润色与 Rebuttal 答辩应对的科研工作者;
- 软件研发与算法工程人员:需要阅读大型未知代码库、自动生成规范函数注释与技术架构图表的工程师;
- 重视数据安全与隐私的研究团队:希望结合本地私有化模型,在完全内网隔离环境下分析敏感研究数据或专利文档的团队。
不适合选用:
- 零基础且完全排斥终端命令的普通用户:项目需要基本的 Python 运行环境准备与配置文件编辑能力,如果完全不会使用命令行,安装环境时可能会感到繁琐;
- 寻求多租户公有化 SaaS 运营的企业:本项目定位于个人与小团队的学术生产力平台,未内置多租户用户计费、层级权限管理与企业级审批流功能。
常见问题
{collapse-item label="点击 PDF 论文精读插件时提示缺少解析模块怎么办?"}A:PDF 深度解析依赖 pymupdf 与 pdfplumber 等文档分析库,执行 pip install pymupdf pdfplumber 完成模块补齐即可正常使用。{/collapse-item}
{collapse-item label="系统是否支持完全断网的离线环境运行?"}A:完全支持。只需在本地部署 Ollama 等开源模型推理框架,并在配置中将模型请求地址指向本地运行端口,系统即可在完全断开外网的环境下稳定提供学术问答与文献处理服务。{/collapse-item}
{collapse-item label="为什么输入长文本或处理大文件时响应变慢?"}A:模型接口单次处理包含上下文窗口限制。对于几十页的长篇 PDF,插件底层会先执行文本分块与分段处理策略,因此整体处理耗时取决于文件长度与接口的吞吐速度,属于正常现象。{/collapse-item}
{collapse-item label="如何编写并集成属于自己的专属学术插件?"}A:只需在 crazy_functions 目录下新建一个 Python 文件,按照现有插件的入参规范定义核心执行函数,系统启动时会自动扫描并将该插件注册为前台界面的快捷调用按钮。{/collapse-item}
源码获取
建议先转存到自己的网盘中再进行下载。在手机或电脑端打开上方链接,点击「保存到网盘」,随后在客户端的网盘文件列表中即可直接下载解压。