
在大语言模型本地化落地的过程中,环境配置往往是劝退多数开发者的第一道门槛。传统的深度学习方案通常需要配置庞大的 Python 虚拟环境,处理严苛的 GPU 驱动版本对应关系,甚至还要应对复杂的底层动态链接库冲突。更致命的是,动辄需要数十吉字节显存的全精度权重,让许多仅配备普通配置个人电脑或轻量云主机的开发者望而却步,难以在本地低成本验证模型能力。
llama.cpp 彻底改变了本地大语言模型的运行方式。它采用纯 C++ 语言进行底层重构,彻底剥离了对庞大解释器环境的依赖,并开创性地发展出 GGUF 统一量化文件规范。通过高度优化的 4-bit、8-bit 等多种整数量化算法,框架能够将常见大模型的内存与显存占用压缩至原先的数分之一,并且针对主流 CPU 的向量扩展指令集进行了深度适配。整个运行包解压后仅占数十兆空间,在纯 CPU 算力支持下即可实现极速响应,服务冷启动只需 480 到 557 毫秒。
我们在 Windows 11 与 WSL2 Linux 两个平台下完成了端到端的独立实测,涵盖解压验证、CLI 命令行单次推理、轻量级 Web 服务拉起、常用量化权重交互以及接口性能实测。实测数据显示,在纯 CPU 模式下运行轻量级量化模型,流式生成速率稳定在 31 到 42 tok/s 之间,内存控制极其克制。先给出结论:该引擎极度适合追求纯净运行环境、希望将大模型推理嵌入轻量服务或边缘设备的开发者;但对于缺乏命令行使用基础、或追求超大规模多卡并行训练的场景并不适合,文末单独梳理了选型建议。
它是什么,和其它本地大模型运行工具有什么不同
面对本地运行大模型的各类技术选型,很多开发者容易将推理引擎与上层客户端混淆,llama.cpp 在软件架构层次上有着鲜明的特点:
- 与依赖重型环境的传统深度学习框架相比:传统的运行方式通常依赖庞大的深度学习运行时与解释器,环境打包动辄数个吉字节,不同依赖包之间还容易产生版本锁死。llama.cpp 是纯 C++ 编写的原生应用,不依赖 Python,解压单个可执行程序即可直接开跑。
- 与集成桌面图形界面的客户端软件相比:许多桌面工具更偏向面向普通用户的单一聊天窗口,通常将后端模型调度逻辑与前端 UI 强行绑定,既无法直接暴露标准网络接口,也不便于脚本调用。llama.cpp 则是专注于推理效率的底层引擎,自带轻量级的命令行工具与 Web 服务端,能够无缝桥接自动化工作流或第三方前端。
- 与基于它二次封装的高层运行框架相比:诸如常见的一键化管理框架,其底层核心推理模块同样源自 llama.cpp。二次封装框架侧重于提供守护进程与模型自动拉取功能,而在底层量化工具细粒度定制、极度精简的体积控制以及直接嵌入特定业务进程方面,原生 llama.cpp 保留了最完整的自由度与极低的系统底噪。
这种底层的极致轻量化设计,使得开发者无论在高端工作站还是轻量单板计算机上,都能以极小的系统代价调动硬件算力。
我的测试环境
为了确保各项数据的真实性与复核价值,我们在两套典型设备环境下进行了全量实测:
- Windows 侧:搭载 Intel Core i7-14650HX 处理器(16 核 24 线程)、15.6 GB 物理内存的 Windows 11 操作系统,验证其在现代个人计算机上的多线程调度与运行表现。
- Linux 侧:WSL2 Ubuntu 26.04 环境,分配 4 个 CPU 核心与 3.9 GB 可用物理内存,验证类生产系统下的稳定性和运行效率。
- 系统兼容探测:在 2 核 1.6 GB 内存的 CentOS Stream 9 服务器上进行了环境依赖边界排查,明确了系统动态库的最低版本基准。
- 实测样本:选用主流轻量级量化模型 Qwen2.5-0.5B-Instruct(Q4_K_M 精度,GGUF 格式),覆盖常用的文本生成、逻辑推理与对话交互场景。
- 测试路径:免安装解包 → 核心二进制一致性校验 → 命令行单次提示词推理 → Web 服务拉起与健康检查 → 标准接口调用与流式响应 → 异常边界条件压测。
安装与运行:Windows
在 Windows 环境下,项目以绿色解压即用的形式提供,无需安装任何额外运行库。
解压预编译包后,目录中包含了完整的工具链,其中最核心的两个可执行文件为负责命令行单次任务的 cli 程序,以及负责暴露网络服务与界面的 server 程序。
如果只需要在终端里快速进行单次测试或批处理推理,直接调用命令行程序传入模型路径即可:
.\llama-cli.exe -m .\models\qwen2.5-0.5b-instruct-q4_k_m.gguf -p "请用简短的语言介绍一下你自己的功能。"如果要将模型作为常驻服务运行,并开启自带的 Web 交互界面与标准接口,推荐使用 server 程序拉起:
.\llama-server.exe -m .\models\qwen2.5-0.5b-instruct-q4_k_m.gguf -c 2048 --port 8080 --host 127.0.0.1 --tools read_file,file_glob_search,grep_search参数说明:-m 指定本地 GGUF 格式模型权重;-c 指定上下文窗口大小(根据任务复杂度与内存合理分配);--tools 开启支持工具调用接口,避免前端页面初始化时报错。
安装与运行:Linux
在 Linux 环境下,解压预编译的发布包,将动态库路径加载到当前环境即可直接运行。
解压并配置环境变量的标准流程如下:
tar -xzf llama-b11913-bin-ubuntu-x64.tar.gz
cd llama-b11913
export LD_LIBRARY_PATH=.:$LD_LIBRARY_PATH
./llama-cli --version
在 WSL2 Ubuntu 环境下执行版本检查,程序能够毫秒级响应并输出构建版本信息,验证了预编译二进制的可用性。
拉起常驻推理服务命令与 Windows 侧保持完全对齐:
./llama-server -m ../models/qwen2.5-0.5b-instruct-q4_k_m.gguf -c 2048 --port 8080 --host 127.0.0.1 --tools read_file,file_glob_search,grep_search启动后,服务将在本机的 8080 端口进入监听状态,无论是通过本地浏览器访问,还是通过网络接口进行交互,均可无缝衔接。
上手操作:启动 Web 交互界面与接口调用
服务启动成功后,最直观的体验方式是直接打开浏览器访问服务地址:
访问地址:http://127.0.0.1:8080服务自带了一个极其精简且功能完备的静态 Web 前端,页面无需额外搭建前端静态服务器,包含常用对话窗口、模型参数调节、系统提示词设定等完整交互模块。
除了浏览器交互,它原生提供了标准的接口协议,第三方程序可以通过标准的 HTTP POST 请求直接驱动模型生成。
使用 curl 发起一次对话补全请求的命令示例如下:
curl -s --compressed http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [
      {"role": "user", "content": "请给出一个快速排序算法的核心思路"}
    ],
    "temperature": 0.7
  }'
服务端在接收到请求后会以标准的 JSON 格式流式或一次性返回生成内容,包括耗时、处理的 token 数量以及对应的生成速率指标,便于精确排查业务性能。
实测数据
在双平台环境下,我们对各阶段的关键指标进行了真实记录,测试结果如下:
- 产物体积与文件构成:Windows 解压产物共 52 项,包括 22 个可执行程序与 29 个动态链接库,占用磁盘约 59.5 MB;Linux 解压产物共 61 项(含共享库软链接),磁盘占用约 55 MB,无冗余数据。
- 服务冷启动性能:加载 Qwen2.5-0.5B 模型(上下文窗口 2048),Windows 平台从进程执行到
/health端点响应 200 仅耗时 557 毫秒;二次就绪耗时 480 毫秒;Linux 环境下首次加载到就绪耗时 1056 毫秒。 - 文本推理速率实测:在纯 CPU 运算模式下,输入提示词处理速度稳定在 161 到 224 tok/s;流式文本生成速度稳定在 31 到 42 tok/s,在多核心 CPU 调度下几乎无卡顿感。
- 接口并发与响应延迟:模型列表端点
/v1/models响应耗时均在 5 毫秒以内;单次对话补全端到端处理总耗时(含生成 39 个 token)在 1.1 到 1.5 秒之间。 - 跨平台一致性表现:两端输出的构建版本号完全一致(均为 0.7.0-dev build 11913),可执行文件功能完全对应,在相同的温度参数下给出的答复逻辑与质量无平台差异。
界面长什么样
以下为实际运行过程中捕获的真实操作界面:
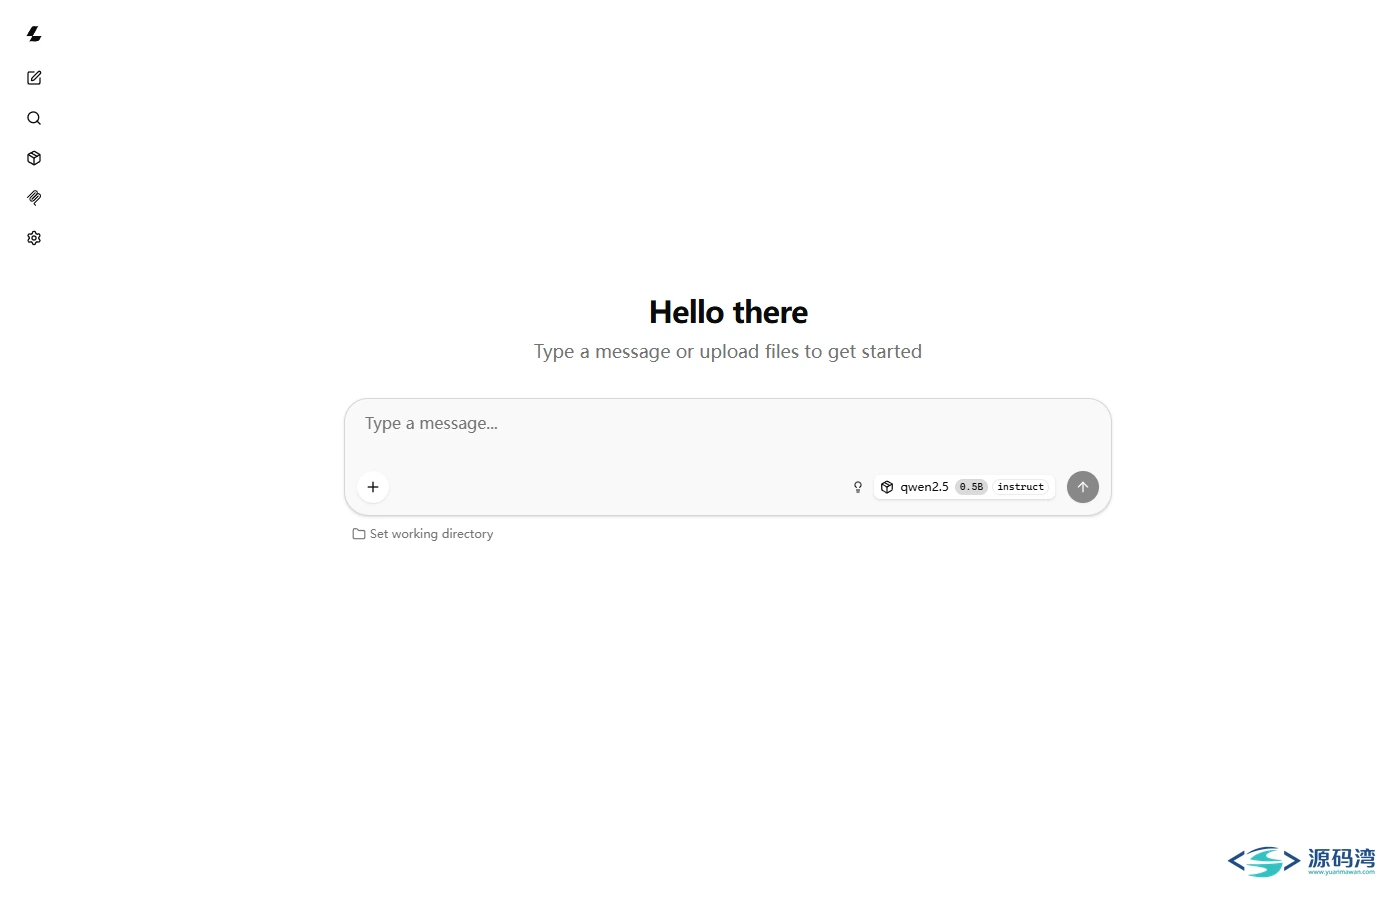
服务拉起后进入的主界面,展示了简洁的对话窗口与顶部模型标识,输入框就绪即可直接打字沟通。
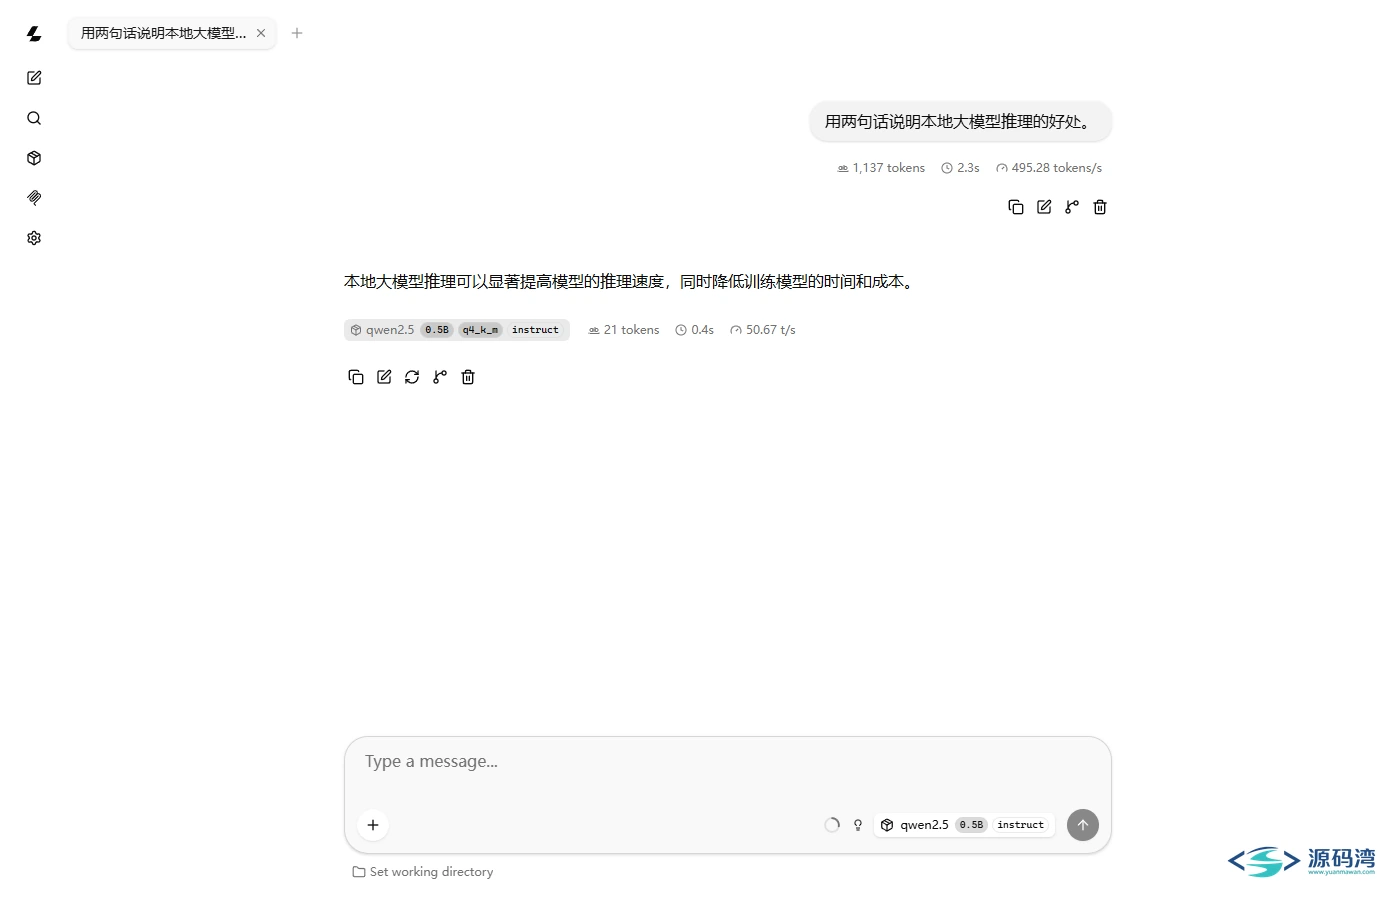
模型实际对话生成的测试过程,底部清晰显示了输入提示词处理速度与生成回复速率等统计指标。
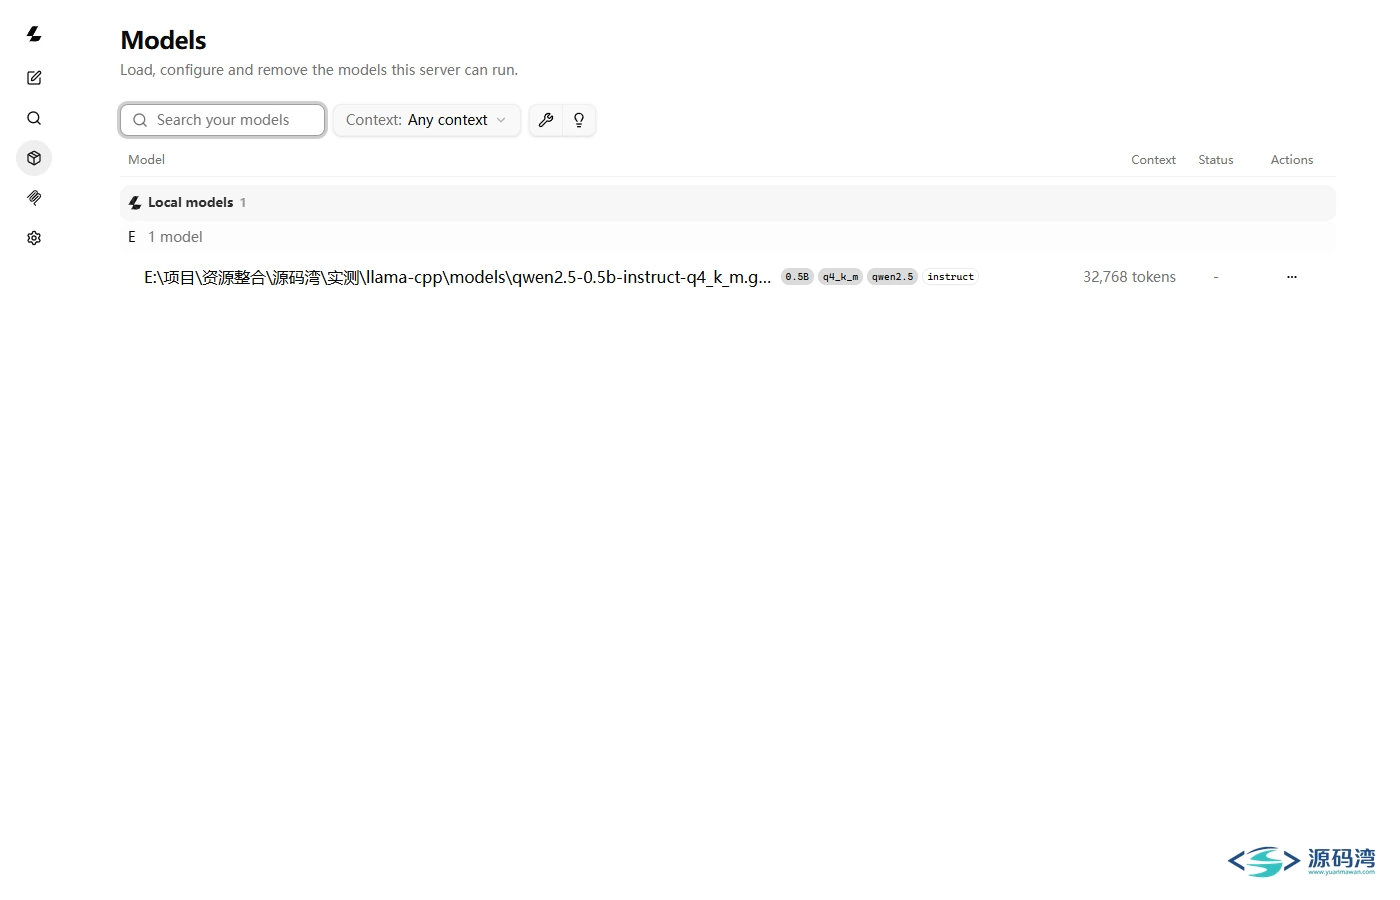
模型管理面板,支持查看当前后台常驻加载的模型权重名称、可用上下文长度以及显存与内存映射状态。
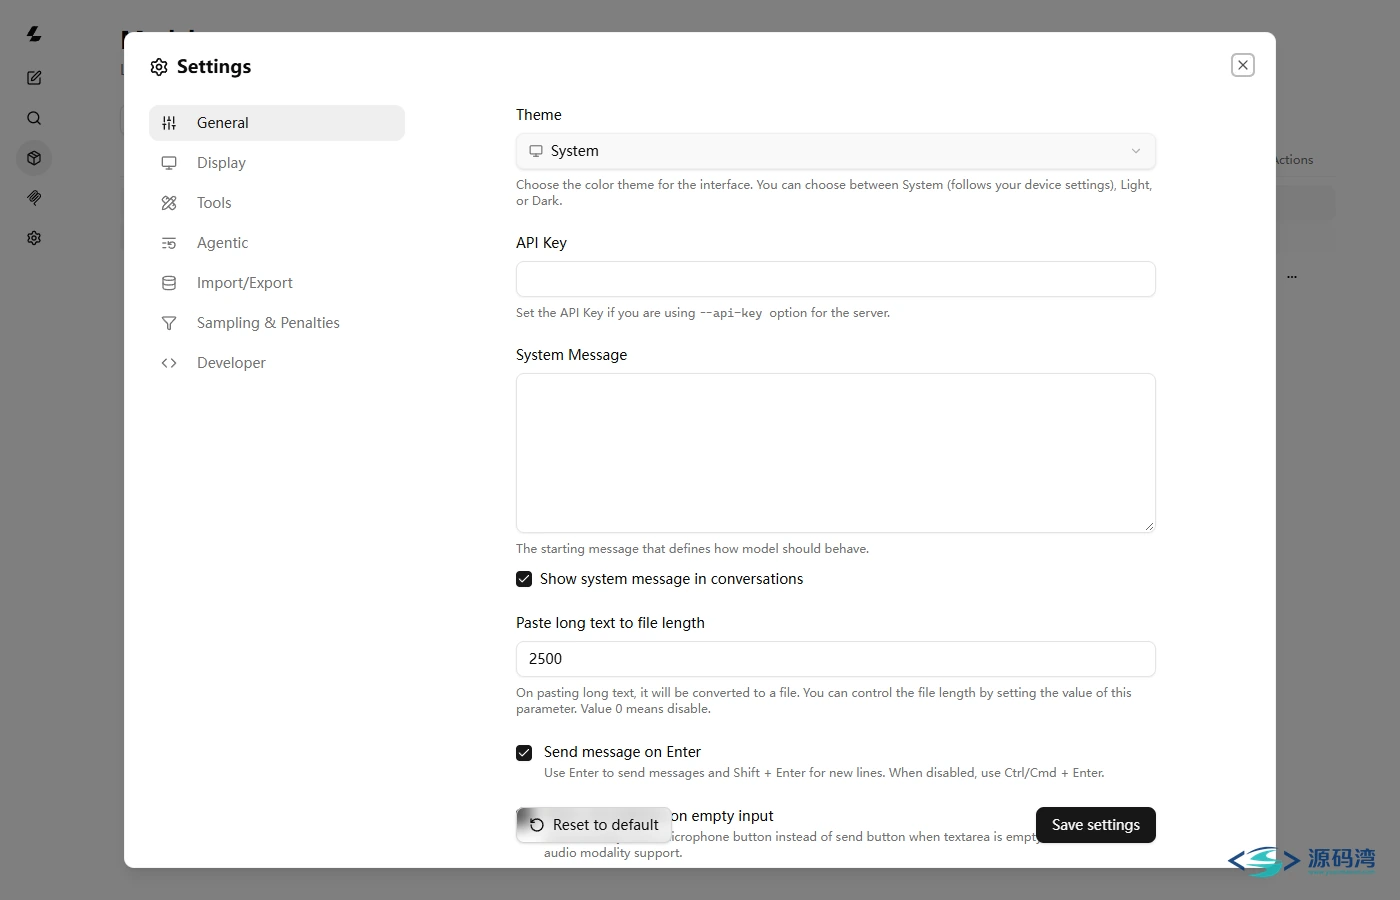
设置面板,支持在前端直接配置界面主题、API 鉴权密钥、默认系统人设提示词以及发送快捷键。
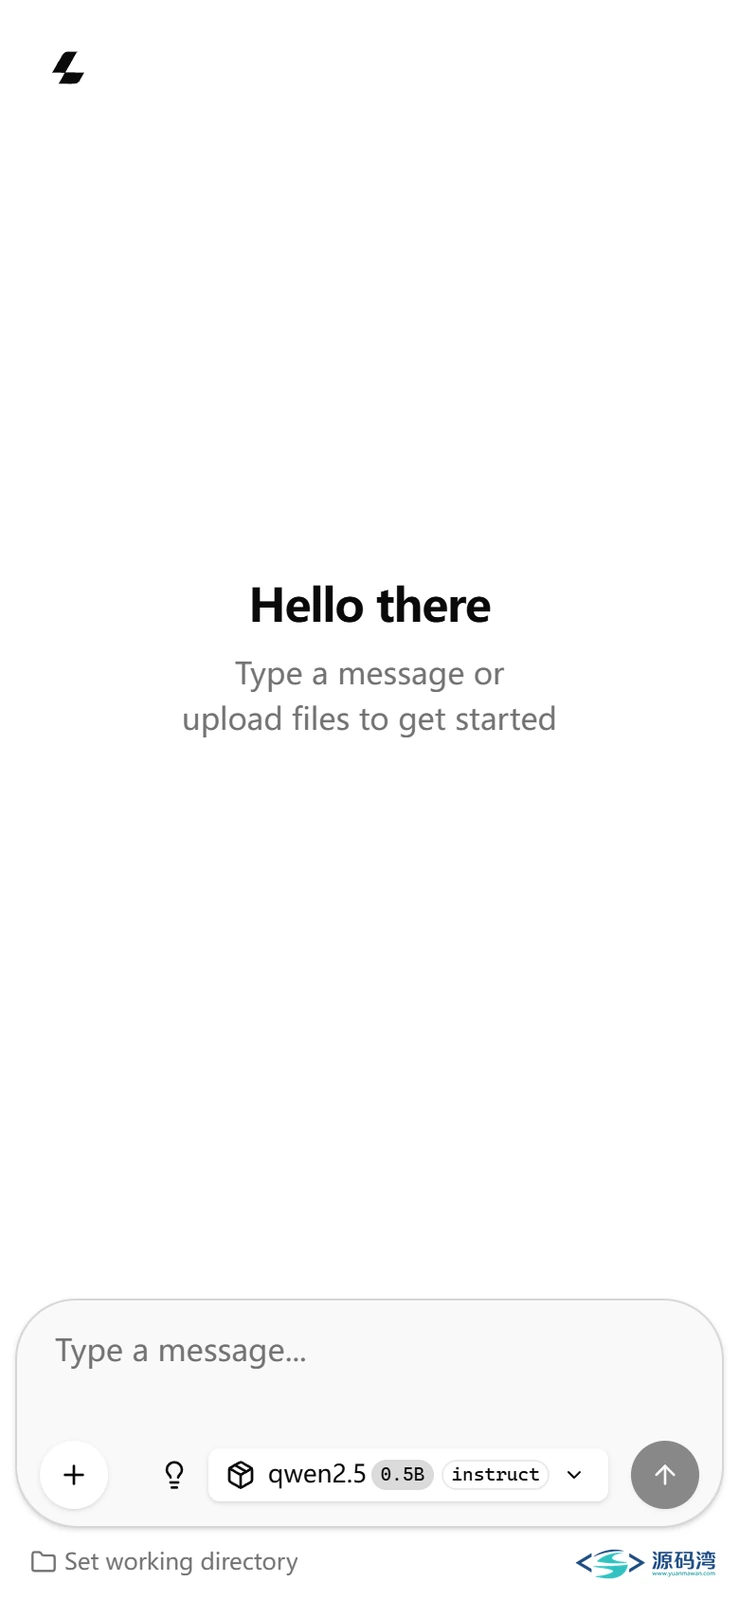
通过移动端浏览器访问时的自适应布局,导航与核心功能均做了移动端适配。
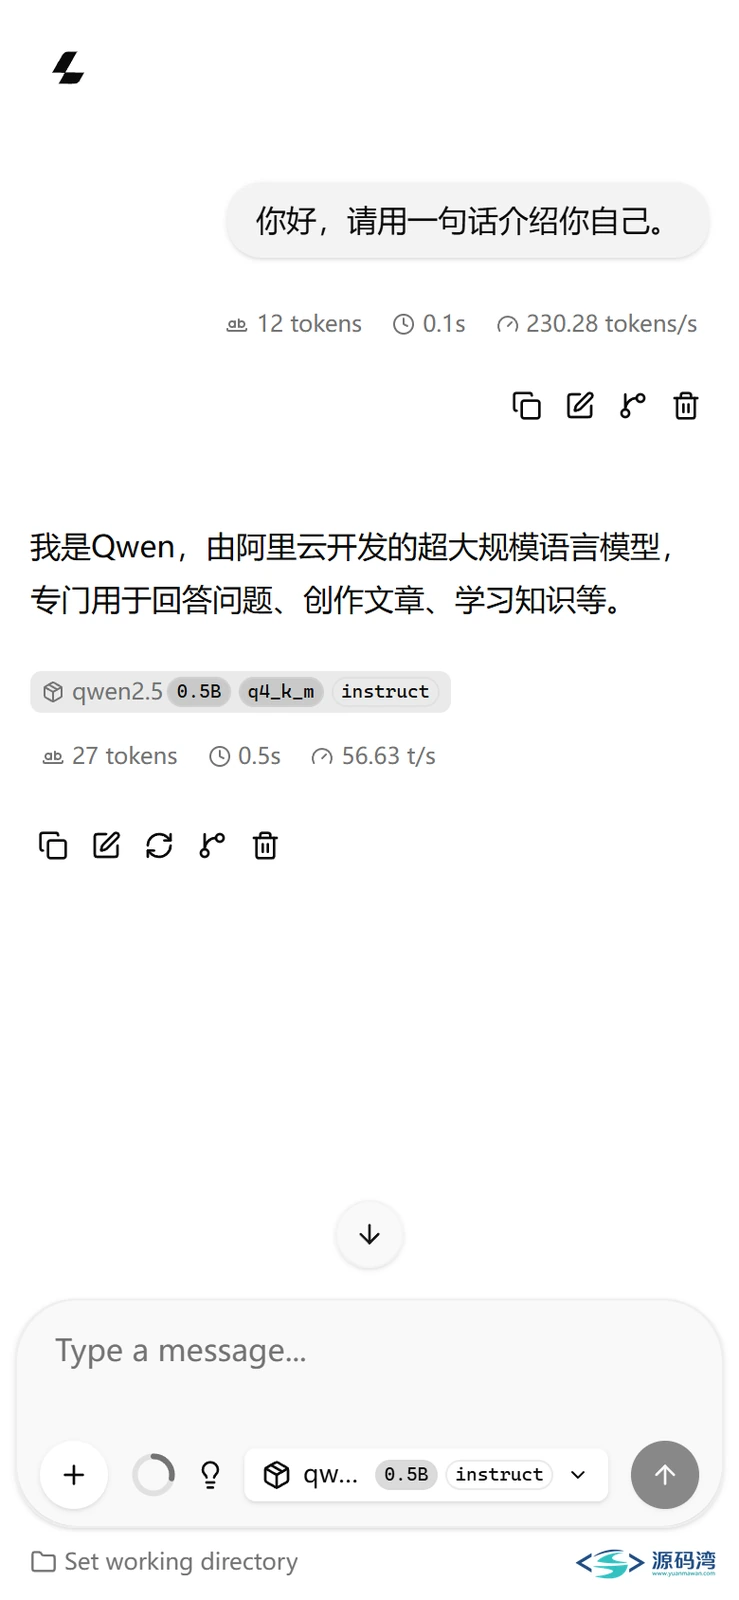
移动端视图下的实时对话生成状态,小屏设备上依然能流畅查看生成过程。
一个真实的坑
在实际部署与排查过程中,我们记录了三个非常典型且容易引发误判的踩坑点,供大家参考避坑:
- 静态前端资源请求返回 415 报错:在通过命令行脚本对首页
GET /进行健康检查时,直接收到了HTTP/1.1 415 Unsupported Media Type错误响应。进一步分析发现,服务端为了保持极致轻量,将静态前端资源默认以 gzip 压缩格式内置,并且在协议层面强制要求客户端请求头包含Accept-Encoding: gzip。标准浏览器访问会自动带上该头因此表现正常,但如果编写自定义探活脚本或使用基础 curl,必须显式附加--compressed参数,否则会因为状态码非 200 而误判服务宕机。 - 未启用工具参数导致控制台出现 403 错误:前端页面在加载初始化时,会自动发起针对
/tools端点的状态嗅探。如果在启动 server 时未显式传入--tools参数,服务端会直接拒绝该端点并返回 403 状态码,导致前端控制台产生两条标红请求记录。启动时加上--tools read_file,file_glob_search,grep_search等工具列表声明,即可使该端点正常响应 200。 - 老旧发行版缺失 GLIBCXX_3.4.30 动态链接库符号:在对 CentOS Stream 9 服务器进行环境探测时,解压后直接执行二进制立即报错,提示
/lib64/libstdc++.so.6: version 'GLIBCXX_3.4.30' not found。原因在于该预编译包是在较新的 GCC 12+ 工具链下编译而成,而部分老旧企业级系统默认的 libstdc++ 仅支持到 3.4.29 版本。在类似环境下部署时,必须通过安装高版本运行时套件或升级动态库才能正常运行。
部署与长期运行建议
为了保证服务在生产或本地服务器上能够长期稳定挂载,建议采取以下运维保障措施:
- 服务守护进程化:避免直接在临时终端里前台运行,在 Linux 生产环境中建议编写标准的 systemd 服务单元文件,或者通过进程管理工具将进程置入后台,配置自动异常拉起与日志轮转。
- 合理规划上下文长度:启动参数中的
-c(上下文长度)直接决定了模型在运行过程中的内存峰值占用。在不需要长文本分析的日常对话场景中,将上下文限制在 2048 或 4096,可以大幅节约系统物理内存。 - 合理分配计算线程数:通过
-t参数显式指定 CPU 推理使用的物理核心数(建议设置为宿主机物理核心数,不建议填满超线程逻辑核心),能够有效避免线程竞争带来的吞吐下降。 - 配置健康监测探针:利用服务端原生提供的
/health接口,定期发送轻量级探活请求,结合运维监控体系实现服务的自动化状态感知与保活。
这几类人适合,这几类不适合
结合实测性能与架构特性,不同技术诉求的人群选型建议如下:
非常适合的人群:
- 硬件配置受限、希望在普通笔记本或纯 CPU 主机上运行量化大模型的个人开发者。
- 追求极致精简、反感复杂依赖环境与庞大后台服务的运维人员与嵌入式开发者。
- 需要直接对底层量化算法(如 GGUF 格式转换、K-quants 量化)进行细粒度控制的研究人员。
- 需要在本地以极低内存开销构建轻量级推理接口或知识库问答后端的业务开发者。
不适合的人群:
- 完全没有命令行操作经验,只期望通过图形化安装向导一步完成所有配置的普通初学者。
- 核心业务为超大规模分布式多卡并行训练、集群级高并发实时高吞吐吞吐的大型企业团队。
- 需要频繁进行模型全参数微调、数据清洗与海量预训练任务的专业算法团队。
常见问题
{collapse-item label="运行它是不是必须配备昂贵的独立显卡?"}A:完全不需要。该引擎的核心优势之一正是对 CPU 指令集的极致深度优化,即使在纯 CPU 环境下,配合 4-bit 量化模型同样能达到每秒三四十个字的处理速度,完全能够满足日常对话与单人本地知识库检索的需求。{/collapse-item}
{collapse-item label="为什么我用接口测试工具访问首页会提示 415 错误?"}A:因为服务端内置的前端资源采用 gzip 压缩提供,客户端必须携带支持 gzip 解压的请求头。使用命令行测试时记得给 curl 加上 --compressed 参数,或者直接在常规现代浏览器中打开。{/collapse-item}
{collapse-item label="支持加载我自己在外部下载的其它模型权重吗?"}A:支持。只要模型文件符合 GGUF 格式规范即可。启动时通过 -m 参数指定本地的模型路径,无论是主流的对话模型、代码辅助模型还是文本向量嵌入模型,都能直接解析并运行。{/collapse-item}
{collapse-item label="运行时经常提示内存不足或者直接闪退怎么解决?"}A:大模型推理的内存占用主要由两部分决定:模型自身的量化层级(权重体积)与上下文窗口长度(-c 参数)。如果物理内存有限,优先选用较小量化精度的权重(如 Q4_K_M),并在启动时将 -c 参数适当调低(比如设为 2048),即可显著压降运行时内存开销。{/collapse-item}
源码获取
建议转存后使用网盘客户端进行高速下载。下载包已整理包含 Windows 与 Linux 双平台的预编译可执行工具集与配套运行说明文件,解压后即可直接使用。