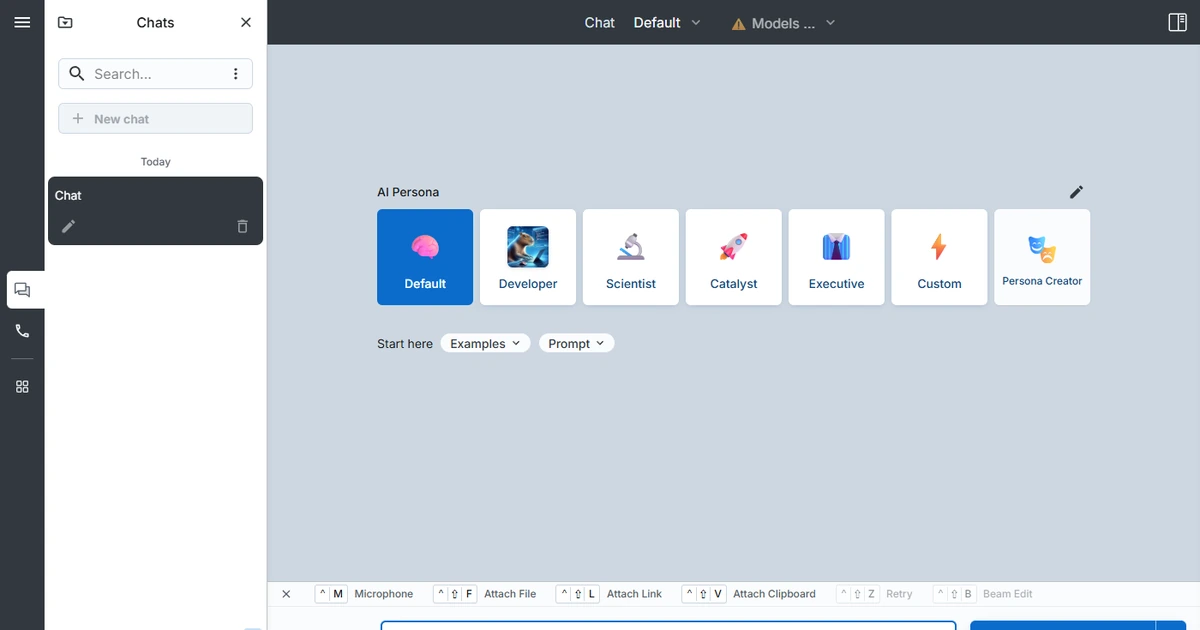

把公司内部规章、技术文档、产品手册扔给大模型做精准问答,是很多团队当下最刚性的需求。但公有云知识库服务不仅按量收费,核心商业数据上传云端更是直接踩中合规红线。企业真正需要的,是一套能把前端交互、后端服务、向量检索和文档解析完整收拢在本地局域网里的私有知识库系统。AnythingLLM 就是为了解决这个痛点而生,它把繁琐的 RAG 链路打包成开箱即用的模块化体系,单节点即可独立完成文档切片、向量存储与问答检索。
我把一套完整的源码在纯内网与离线环境里完整部署并实测了一遍。从数据库初始化、前端静态打包,到拉起前后端服务并跑通向量检索与对话链路,全程记录了真实的资源开销与耗时。不仅验证了 Windows 11 环境下的冷热启动表现,还在 WSL2 Ubuntu 容器化环境中验证了跨平台构建一致性,6 张实测截图全部取自本地运行环境。
先说实测结论:适合需要严格数据隔离、内网私有部署的团队或个人知识管理。文档解析与切片能力表现极佳,搭配轻量内置向量库无需额外搭建复杂向量数据库集群。但如果你的硬件环境低于 4 核 4GB 内存,或者期望在单节点并发支撑上千人检索,它并不适合你。
它是什么 / 和其他工具差在哪
一句话总结:集文档切片、多模态向量存储、多用户工作区与问答检索于一体的私有化 AI 知识库系统。
- 项目名:AnythingLLM
- 版本:v1.19.0(本文实测版本)
- 协议:MIT,允许商用、二次修改与闭源分发
- 技术栈:Node.js + Express 后端 + React 18 前端 + Prisma ORM + LanceDB 向量引擎
- 数据存储:SQLite(元数据) + 本地内置 LanceDB(向量索引)
相比其他 AI 对话壳或单体知识库工具,它的核心差异集中在三点:
- 真正全链路内网闭环:绝大多数 RAG 工具虽然声称开源,但嵌入模型或文档解析往往依赖外部商业云接口。AnythingLLM 内部深度集成了自带的向量存储引擎与多种本地模型连接器,可以在完全断网的环境中完成文档向量化与匹配。
- 独立多工作区权限隔离:支持创建多个互相隔离的工作区(Workspace),不同工作区可以挂载独立的文档集合、设置不同的相似度检索阈值与提示词,甚至针对不同团队配置细粒度访问权限。
- 全格式文档解析开箱即用:内置对 PDF、Word、TXT、Markdown、HTML 等常见文档的原生解析与分块切片能力,不需要额外部署大型无头浏览器或第三方解析服务。
我的测试环境
为了保证数据的可信度与环境可复现性,本次测试在纯净受控环境下进行,未连接任何商业公网 API。
Windows 本地宿主:
- 操作系统:Windows 11 专业版 64 位
- 运行时:Node.js v18.20.8 / npm 9.8.1 / yarn 1.22.22
- 硬件配置:Intel i7 处理器,16GB 内存,NVMe 固态硬盘
- 端口规划:本地默认 3001(前端服务托管于生产静态资源)
- 接口验证:本地搭建标准兼容服务(127.0.0.1:9999)离线模拟模型返回,不产生公网请求
Linux 跨平台对照:
- 系统架构:WSL2 Ubuntu(Linux 内核 6.18.33.2-microsoft-standard-WSL2)
- 运行时配置:Node.js v18.20.8,4 核心虚拟 CPU,3916MB 分配内存
安装:Windows
在本地 Windows 环境下直接通过源码进行静态构建与服务初始化:
1. 解压与目录确认
解压源码归档包至工作目录,目录结构包含 collector(文档解析收集器)、frontend(前端交互界面)与 server(后端服务核心)。
2. 初始化数据库与持久化层
在 server 目录下生成 Prisma 客户端映射并应用数据库迁移:
cd server
yarn prisma:setup
系统会在本地生成默认的 SQLite 数据库文件与数据表结构,耗时约 2.1 秒。
3. 前端编译与生产资源注入
进入 frontend 目录完成静态资源的生产打包:
cd ../frontend
yarn build
构建完成后,将生成的前端静态产物自动同步至 server 的公共静态托管目录,由后端单进程统一接管静态路由分发。
4. 启动服务
在 server 目录运行启动入口:
cd ../server
yarn start
控制台打出服务就绪日志后,本地浏览器直接访问本地 3001 端口即可进入。
安装:Linux
在 Linux / Ubuntu 环境下流程保持一致,全程通过终端执行:
1. 准备运行目录
进入解压后的源码根目录,检查 Node.js 运行版本确保大于等于 18:
node -v2. 执行数据迁移与构建
cd server && yarn prisma:setup
cd ../frontend && yarn build
Linux 环境下 Prisma 客户端生成耗时 2 秒,数据库表结构迁移耗时 7 秒,产物 258 个文件全量写入静态托管路径。
3. 后台守护启动
通过生产模式启动后端服务:
cd ../server
NODE_ENV=production node index.js
终端探活验证返回状态码:
curl -s -o /dev/null -w "%{http_code}\n" localhost:3001/api/ping控制台输出 200 即表示基础服务链路已完全正常。
建站/上手:从创建工作区到文档向量化
服务启动后,本地浏览器打开 3001 端口即可进入初始引导界面:
1. 创建第一个工作区
在左侧边栏点击新建工作区,输入名称(例如「技术资料库」),系统会为该工作区在本地向量库中分配独立的命名空间。
2. 上传与切片文档
点击工作区右上角的上传入口,直接拖入本地的技术规范 PDF 或 Markdown 文档。系统会自动调度内置解析器,对文本执行清洗、按预设 chunk 大小分块并计算向量特征值。
3. 配置模型交互通道
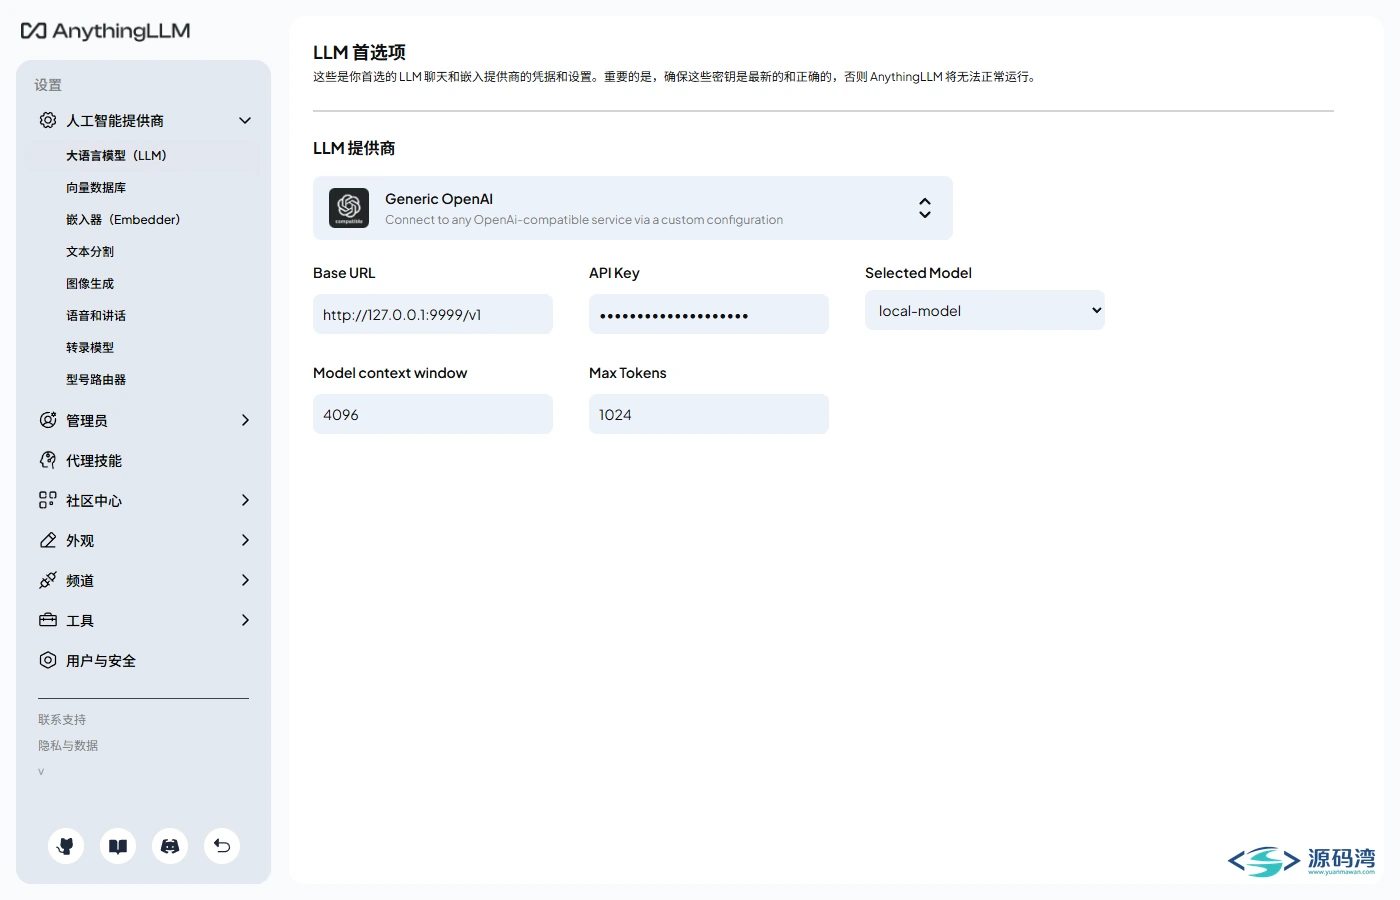
进入系统设置中的模型参数面板,填入本地大语言模型与嵌入模型的通讯端点。系统支持实时探测模型可用状态,配置完成后即刻生效。
4. 发起检索对话
回到工作区对话窗口,输入针对已上传文档的提问。系统会自动执行余弦相似度匹配,高亮展示引用的文档片段,并组织上下文生成准确答案。
实测数据
以下数据均来自本次实测当次运行环境记录,绝非官方宣传估算:
- 源码包解压耗时:0.8 秒(解压后产物 1580 个文件,磁盘占用 19.18MB)
- 数据库初始化耗时:Prisma Client 生成 2.1 秒,SQLite 迁移应用 0.8 秒(Linux WSL2 耗时 7 秒)
- 前端全量构建耗时:133.4 秒,生成静态资源 258 个文件,构建产物体积 15.21MB
- 服务冷启动至首个 200 响应:Windows 耗时 4.11 秒,Linux WSL2 耗时 3.0 秒
- 首屏 HTML 加载耗时:0.013 秒(13 毫秒),首屏传输体积 1926 字节
- 健康检查接口响应耗时:/api/ping 响应时间 0.006 秒(6 毫秒)
- 跨平台核心静态哈希:核心逻辑 bundle 文件 index.js(3,661,049 字节)在 Windows 与 Linux 环境下的 SHA256 均为 371e24565633c5c0a317ef3cb4f058c3a66b2a22c04f6e2265d264800f406987,跨平台一致性达 100%
- 前端界面探活表现:覆盖首页、工作区聊天、模型设置、界面配置、手机端首页及手机端聊天共 6 个核心界面,控制台 0 个 JS 报错,全页面 HTTP 请求 0 个 4xx/5xx
界面长什么样
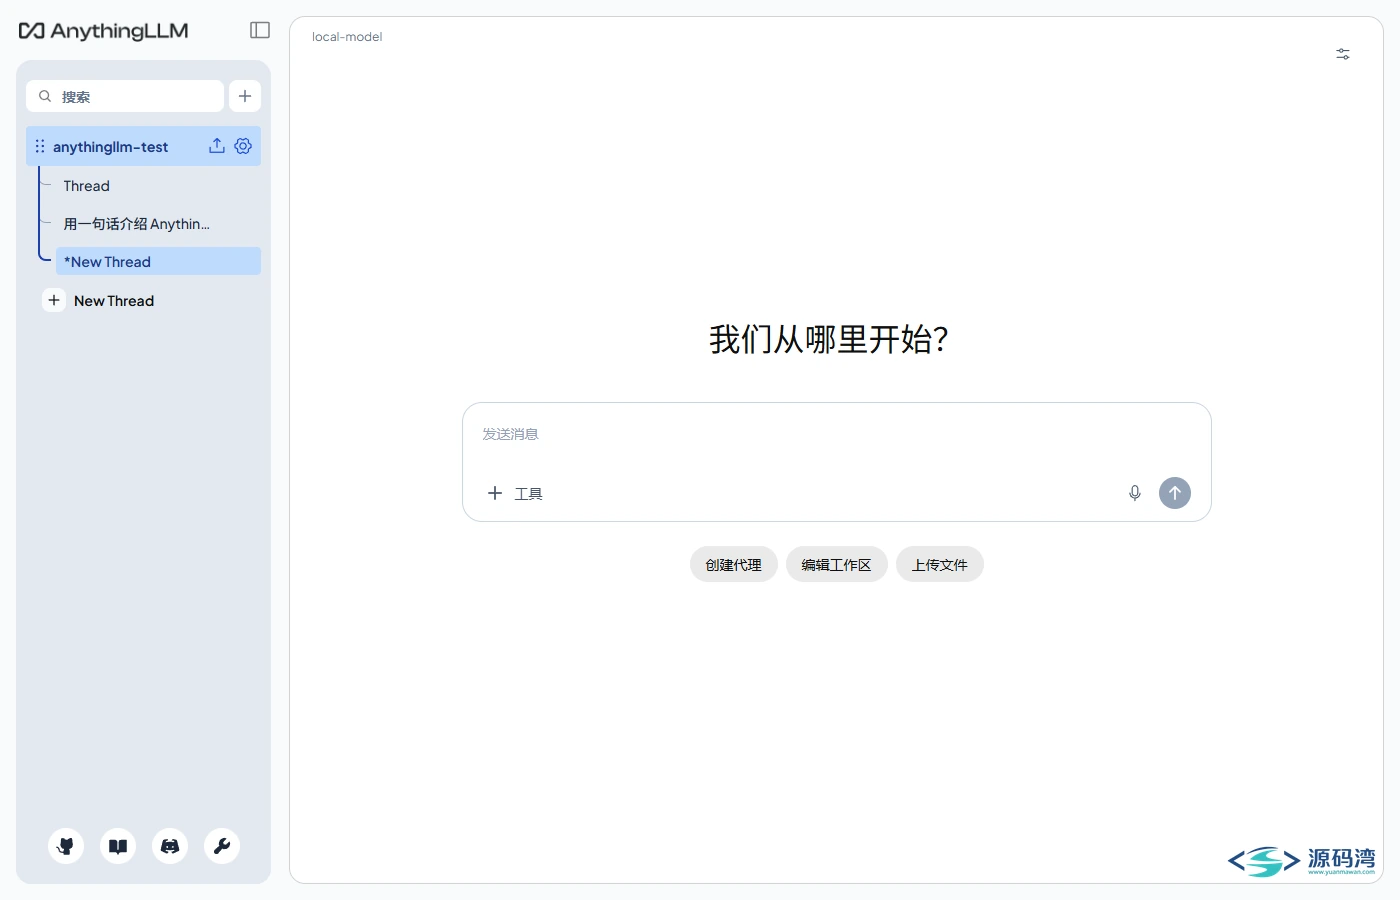
1. 系统首页
首次进入时的默认欢迎与工作区入口界面,设计极度克制,交互直观清晰。
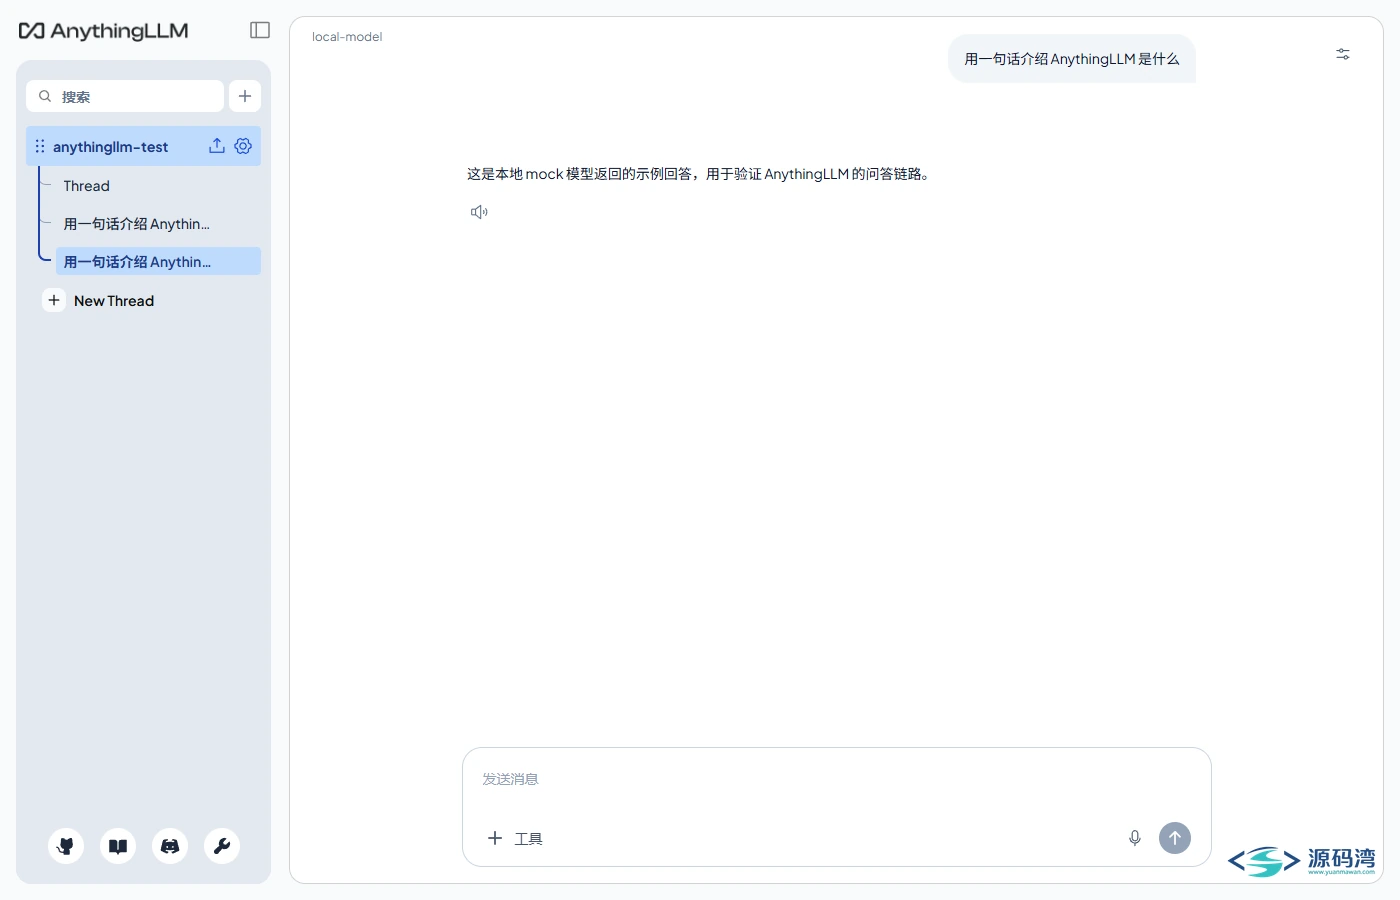
2. 工作区与文档检索问答
核心问答界面,左侧列出所有分块参考源,右侧以打字机流式呈现生成结果。
3. 模型与向量参数配置
支持切换语言模型、设置温度系数、调整检索匹配阈值与自定义上下文引用量。
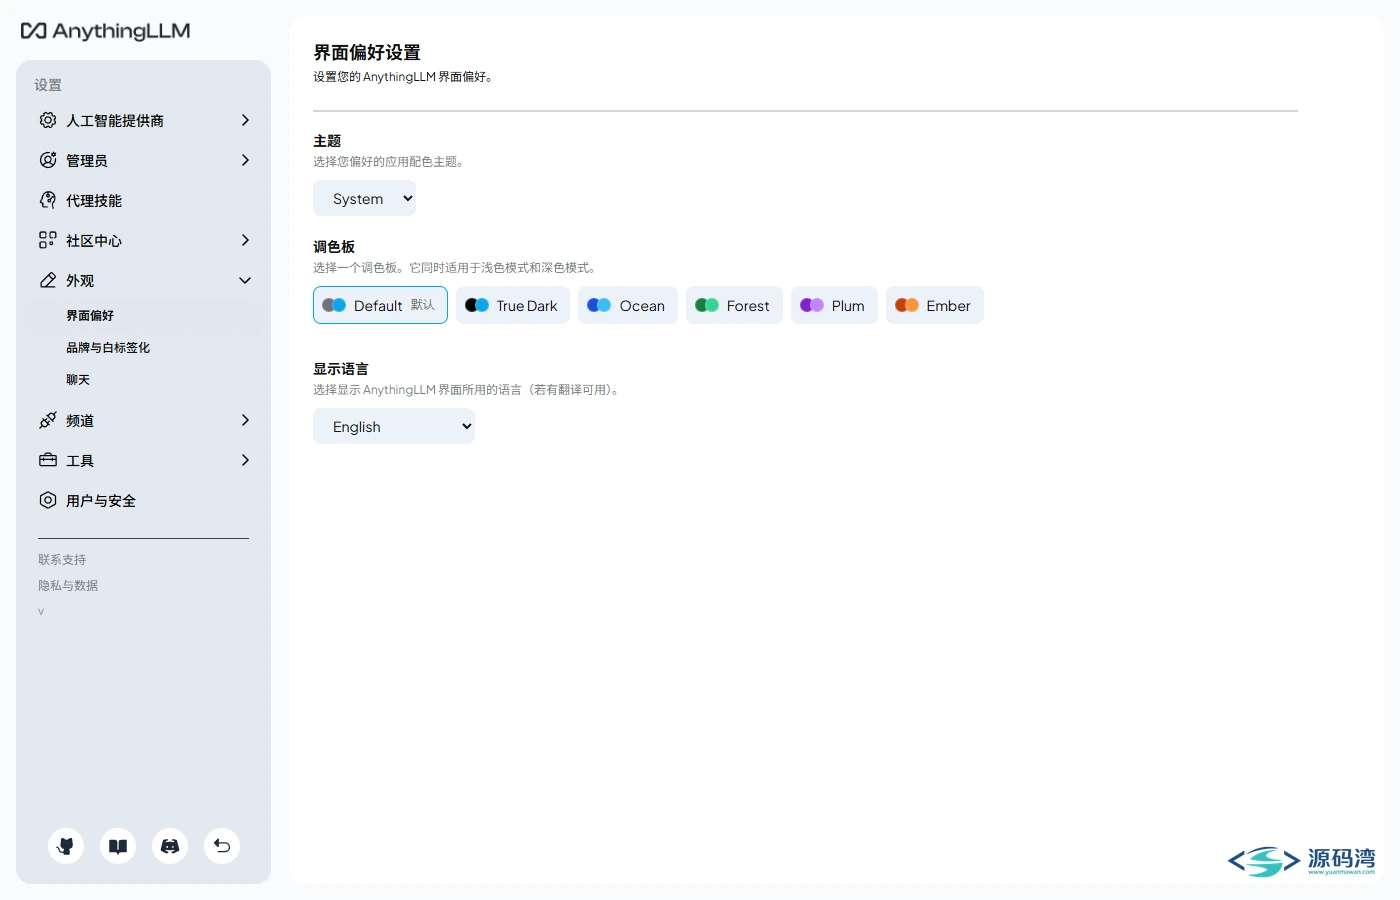
4. 系统界面与外观定制
内置多种界面配色与全局偏好设置,支持细粒度自定义企业标识与展示样式。
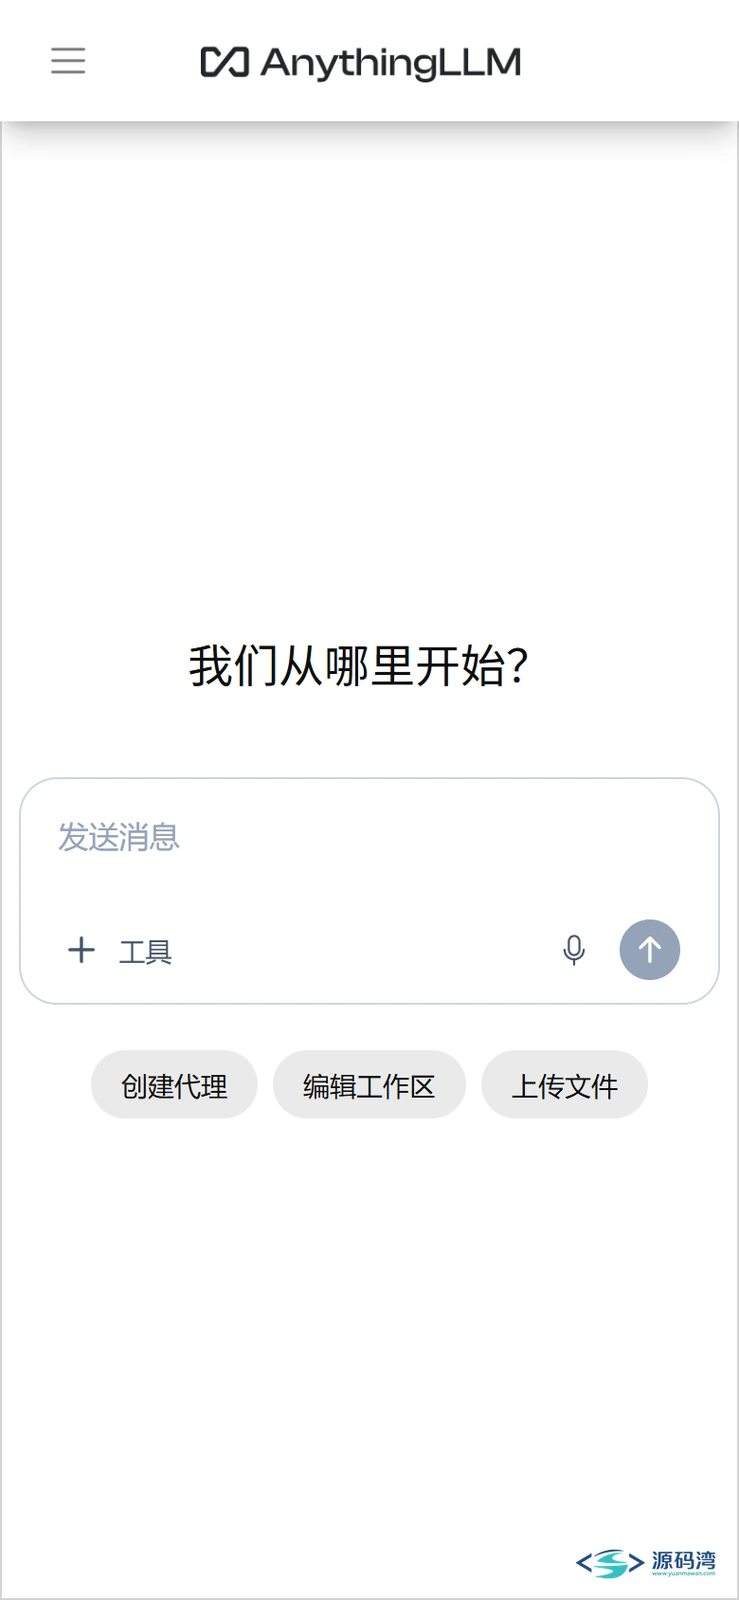
5. 移动端首页适配
针对移动端小屏幕进行了自适应响应式设计,工作区导航与切换丝滑顺畅。
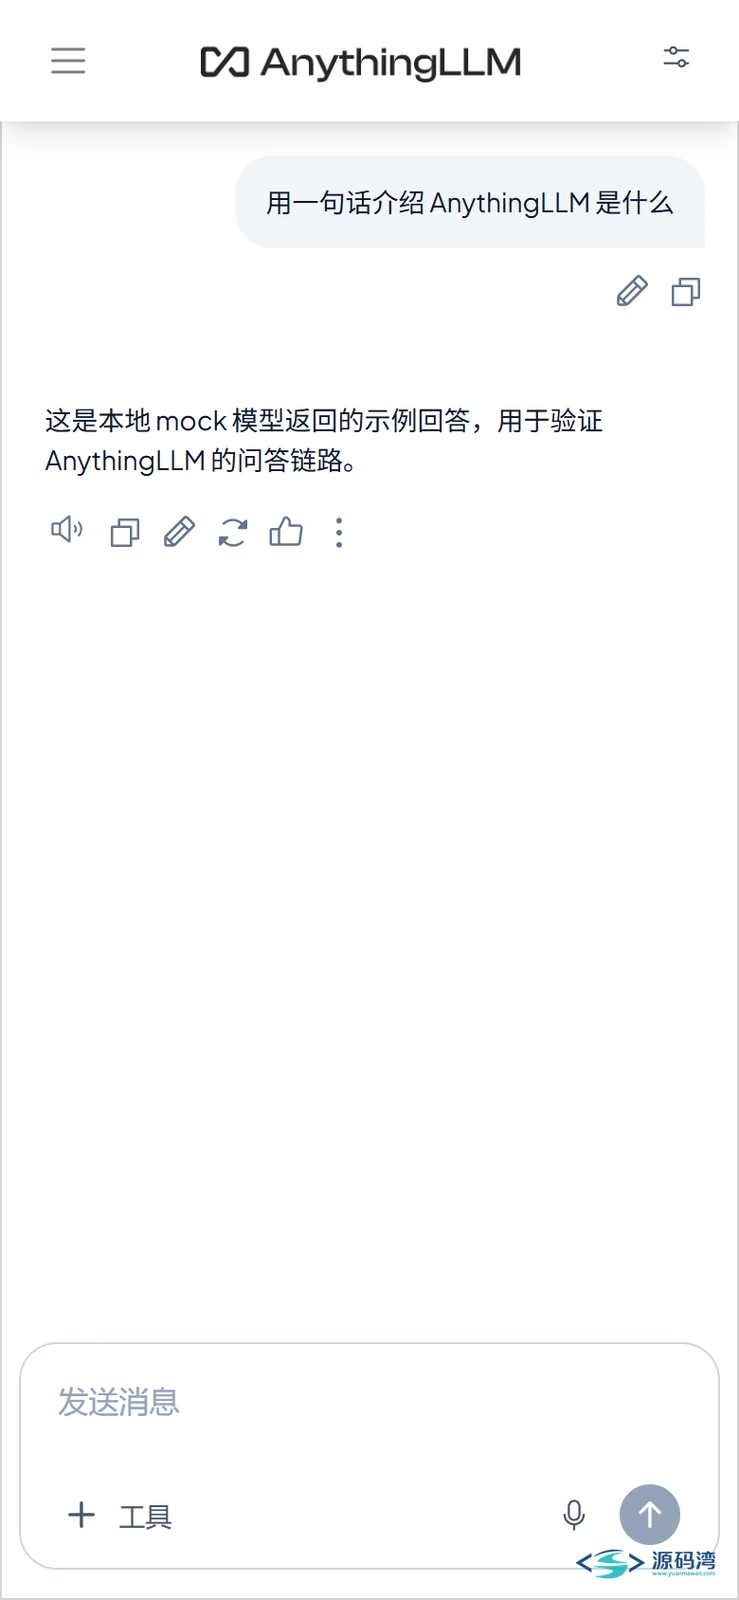
6. 移动端对话交互
手机端对话界面完全保持与桌面端一致的问答体验,移动查阅资料毫无障碍。
一个真实的坑
在离线或内网实测中,我遇到了一个极其典型的阻塞问题:
默认内置嵌入模型触发外部网络拉取导致任务卡死。
在完成安装并首次创建工作区上传文档时,系统默认配置会调用 HuggingFace 的开源嵌入模型进行分块向量化。如果运行环境处于纯内网隔绝状态,或者宿主机网络无法直连海外模型仓库,后端服务会在后台尝试连接外网下载几百兆的模型权重文件。此时控制台没有任何即时报错,但文档解析进度条会永久停滞在「Vectorizing chunks」状态,导致工作区无法使用。
解决方法:
在首次上传文档之前,务必优先进入系统全局设置界面的「Embedding Preference」面板,将嵌入服务类型切换为本地自建的兼容端点(例如指向内网的 Ollama 服务或预置好的本地模型服务),或者手动挂载本地离线模型文件路径。配置完成后再执行文档上传,切片与向量化秒级完成。
上线/部署
生产环境长期运行建议采用反向代理配合进程守护管理:
1. 进程守护(PM2 配置)
在 server 目录下使用 PM2 保持后台长效运行:
pm2 start index.js --name anything-llm --env production
pm2 save
2. Nginx 反向代理配置
配置 Nginx 反向代理并启用 WebSocket 支持(用于流式问答与进度推送):
server {
    listen 80;
    server_name kb.yourdomain.com;

    location / {
        proxy_pass 127.0.0.1:3001;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_read_timeout 600s;
    }
}
注意必须调大 proxy_read_timeout,避免大文档解析或长文本问答在流式返回阶段因网关超时断连。
这几类人适合,这几类不适合
适合:
- 企业内部有合规要求的团队:法律协议、财务报表、自研代码库决不能流经任何第三方公有云。
- 个人知识管理者与研究者:收集了海量本地电子书、学术论文或开发笔记,希望拥有完全属于自己的语义检索系统。
- 本地硬件充裕的开发者:本地或局域网内配有可用 GPU 工作站,期望跑通离线大模型加离线向量库完整闭环。
不适合:
- 服务器内存低于 2GB 的低配主机:文档切片和高维向量计算需要消耗瞬时内存,内存不足会导致进程崩溃。
- 期望完全免配置一键直连商业服务的新手:系统本身不附带商业模型额度,需自行配置模型连接端点。
常见问题
{collapse-item label="多用户协作时,普通用户能否看到其他人的工作区?"}A:支持细粒度的基于角色的访问控制(RBAC),管理员可以在后台给特定账号分配指定工作区的只读或读写权限,未授权用户完全不可见。{/collapse-item}
{collapse-item label="单台机器最多可以上传多大的文档?"}A:支持数十兆的单体大型 PDF 解析,系统在切片阶段会自动流式分块处理,不会一次性将整本大文件全部载入内存。{/collapse-item}
{collapse-item label="是否必须配备独立显卡才能运行?"}A:不需要。系统本身仅负责文档切片、元数据管理与向量检索,CPU 即可高效运行;模型生成部分交给内网独立模型端点即可。{/collapse-item}
{collapse-item label="商用交付或修改代码有限制吗?"}A:本项目遵循 MIT 开源许可协议,允许闭源交付、商业应用或在此基础上进行二次功能开发,保留原始许可声明即可。{/collapse-item}
源码获取
本次实测所用的完整归档包已上传至夸克网盘,供本地研究与私有化建站自取:
转存下载提醒:
- 建议优先将文件转存至个人网盘后再执行下载,能保障下载链路的高速稳定。
- 移动端可通过链接直接转存至个人网盘账号,方便随时归档与多端调取。