
在本地折腾大语言模型,环境配置往往是劝退多数人的第一道门槛。配 Python 虚拟环境、排查 CUDA 驱动版本、编译底层推理库,稍有不慎就会遇到动态库缺失、版本冲突或显存报错。即便费尽周折跑通了模型权重,后续如果想把它接入日常使用的网页前端或工作流脚本,又得自己编写一套兼顾并发、流式输出与显存管理的 API 封装层。
Ollama 彻底重构了本地运行大模型的流程。它将底层多套推理后端、量化运行库与模型调度逻辑全部打包进单一可执行文件,无需复杂的编译安装步骤。框架遵循 MIT 许可,在双平台环境下从启动到端口完全就绪仅需 1 到 22 秒,原生提供兼容规范的 REST 接口与流式响应支持,单条命令即可拉起大语言模型服务。
我们在 Windows 11 与 WSL2 Linux 两个环境下完成了端到端的独立实测,全程记录了服务冷启动耗时、7B 参数量模型 54~58 tok/s 的流式生成速度、CPU 向量推理输出一致性等核心数字,同时摸清了显存调度与低配置服务器运行的边界条件。先说结论:该框架在配备独立显卡的个人工作站与 Linux 开发机上运行极为顺畅,但在内存较小的云服务器上存在明确的性能瓶颈,不适合的人群在文末有单独梳理。
它是什么,和其它本地运行工具有什么不同
面对本地运行大模型的需求,很多人会联想到底层的推理引擎或各类桌面端套壳工具,Ollama 在定位上与它们有着清晰的区隔:
- 与纯底层推理库相比:传统的底层推理引擎通常需要手动编译二进制、配置复杂的量化参数并自行管理权重格式。Ollama 将各类硬件架构优化(包括 CUDA、Vulkan 以及多种 CPU 指令集)全部做了内置封装,用户无需面对复杂的编译链条。
- 与桌面客户端相比:许多桌面工具更偏向面向终端用户的图形聊天窗口,往往将服务绑定在单一界面内。Ollama 则是纯粹的后台推理服务与标准化网关,专注于资源调度与接口暴露,可以无缝对接各类 Web 界面、自动化脚本或知识库检索系统。
- 与手写服务封装相比:框架自带完整的模型生命周期管理机制,支持一键拉取、查看、加载和卸载模型,并原生提供标准的流式对话与文本嵌入接口,省去了大量胶水代码的编写。
它的核心优势在于将本地算力封装为随时可调用的网络服务,让大模型在本地运行得像普通数据库一样稳定与规范。
我的测试环境
为了保证测试数据的真实性与参考价值,我们在两套典型设备环境下进行了全量实测:
- Windows 侧:Windows 11 操作系统,搭载 i7-14650HX 处理器(24 线程)、15.6 GB 物理内存、RTX 5060 Laptop 独立显卡(显存 8151 MiB,驱动版本 591.91)。
- Linux 侧:WSL2 Ubuntu 26.04 LTS(内核 6.18.33.2-microsoft-standard-WSL2),可见 4 个 CPU 核心、3.9 GB 可用内存与 928 GB 存储余量。
- 测试路径:免安装解包 → 基础服务拉起 → 端口状态与版本检查 → 模型清单读取 → 文本对话推理 → 向量嵌入计算 → 异常模型请求测试。
- 测试样本:选用主流的 7B 级别对话模型与 137M 轻量级文本嵌入模型,涵盖主流自然语言处理与知识库检索场景。
安装与运行:Windows
在 Windows 环境下,项目以开箱即用的绿色压缩包形式提供,解压后包含顶层的可执行程序以及存放多种计算后端的子目录。
第一步,将压缩包解压至本地磁盘目录。
第二步,打开终端并执行服务启动命令:
.\ollama.exe serve服务启动后将默认监听本地的 11434 端口。实测在 Windows 平台下,从执行命令到服务完全就绪并返回状态共耗时约 22.9 秒。
第三步,在浏览器或命令行工具中访问本地接口验证服务状态:
curl 127.0.0.1:11434/接口迅速返回 HTTP 200 状态码及提示信息,表明后台推理服务已进入正常待命状态。
安装与运行:Linux
在 Linux 环境下,我们同样测试了预构建二进制包的运行表现。
第一步,解压 Linux 平台的归档包,得到核心主程序。
第二步,通过系统工具排查主程序的依赖项:
ldd bin/ollama实测所有动态链接均准确命中系统内置的基础运行库,没有缺失任何第三方依赖,具备良好的跨发行版兼容性。
第三步,启动后台服务:
./bin/ollama serve在 WSL2 Ubuntu 环境下,服务启动至端口可连仅耗时 1,065 毫秒(约 1.07 秒),启动效率显著优于 Windows 平台。
常用命令与接口调用
框架既支持命令行交互,也支持标准 HTTP REST 接口调用,常见用法如下:
通过命令行管理与交互,常用命令包括启动特定模型、列出模型与查看进程状态:
ollama run qwen2.5-coder:7b
ollama list
ollama ps
通过 REST API 发起调用:
查询运行中的版本信息:
curl 127.0.0.1:11434/api/version响应结果为标准的 JSON 结构体:
{"version":"0.40.11"}发起流式对话请求(以 7B 代码模型为例):
curl 127.0.0.1:11434/api/chat -d '{
  "model": "qwen2.5-coder:7b",
  "messages": [{"role": "user", "content": "你好,请写一个快速排序算法"}]
}'
计算文本的向量嵌入表示:
curl 127.0.0.1:11434/api/embed -d '{
  "model": "nomic-embed-text",
  "input": "源码湾本地实测:向量维度检查"
}'
实测数据
以下所有测试数据均来自我们在当次实测环境中的实际运行产物,无估算或宣传性修饰:
- 主程序文件与体积分级:Windows 平台解包后共计 75 个文件,占用空间约 2,127.7 MB,内置了包含 CUDA、Vulkan 在内的多套计算后端与基础动态链接库;Linux 平台核心运行包精简为 36 个文件与 11 个符号链接,体积约为 72 MB。
- 服务启动耗时:Windows 平台执行启动命令到根路径首次返回 200 耗时 22,945 毫秒;Linux WSL2 环境耗时 1,065 毫秒。
- 基础探活接口表现:访问根路径
GET /,Windows 响应耗时 16.8 毫秒,Linux 响应耗时 1.6 毫秒,均稳定返回 HTTP 200;读取模型清单接口GET /api/tags耗时 394 毫秒。 - 对话生成速率(7B 模型):在配备独立显卡的 Windows 设备上,首次请求冷启动加载权重耗时约 20 秒,首字响应输出耗时 21.6 秒;在随后的流式输出中,生成 33 个 token 耗时 607 毫秒,持续输出速度达 54.3 tok/s;热态请求下的单次生成速率达到 58.1 tok/s。
- 文本向量推理(137M 嵌入模型):在 CPU 运算模式下提取 768 维高维向量,Linux 侧单次计算耗时 2.145 秒,Windows 侧耗时约 8.8 秒。
- 跨平台推理一致性:对同一段中文输入在两端分别进行向量提取,前 4 维浮点数在 Windows 下为 0.030505、0.061257、-0.175246、-0.009523,在 Linux 下为 0.030505、0.061256、-0.175248、-0.009521,差值处于百万分之一量级,完全符合浮点运算累加规则,证实两端推理逻辑一致。
- 异常捕获与容错:请求不存在的模型名称时,接口快速返回 HTTP 404 状态码并附带规范的 JSON 错误信息,服务保持稳定,未发生崩溃或内存泄漏。
界面长什么样
以下为本次实测过程中的实时控制台与接口诊断监控记录:
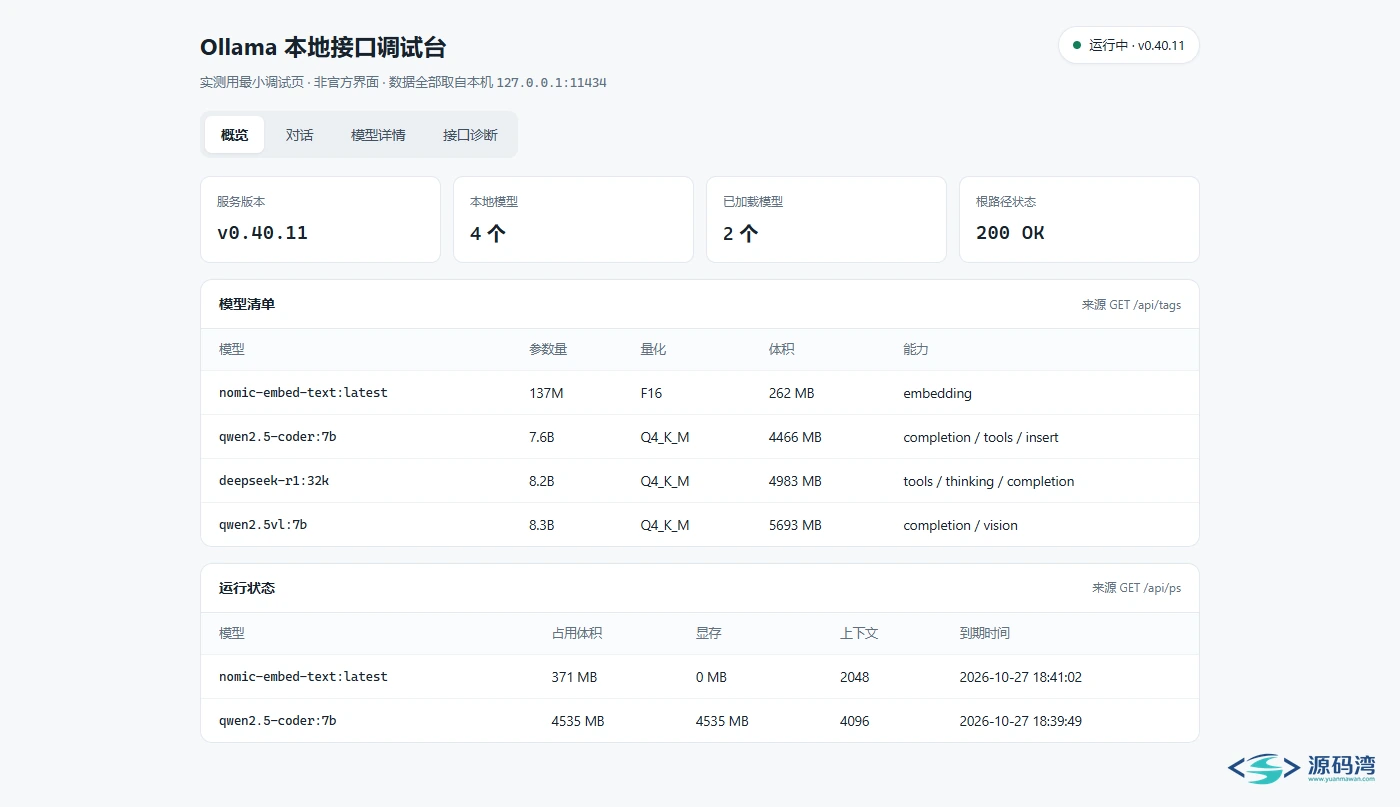
上图展示了本地服务的基础运行概况,包括服务版本、已加载模型数量、根路径连接健康度以及当前在显存中驻留的模型详情。
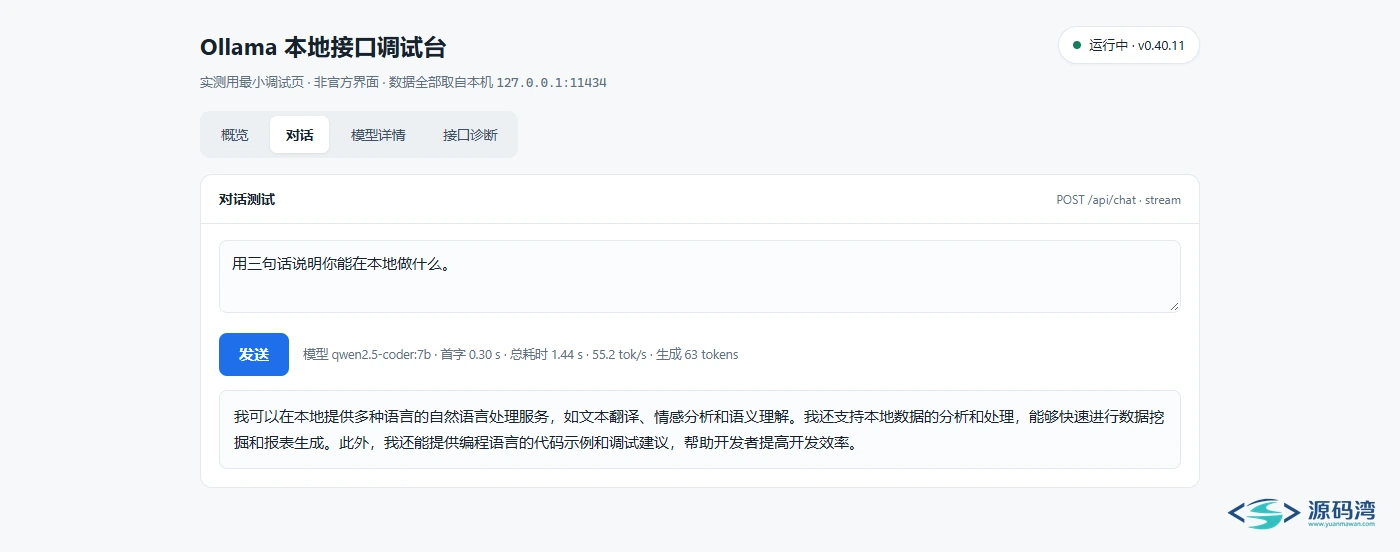
上图为通过标准接口发起流式对话的真实输出场景,记录了首字延迟、持续生成速率以及整体响应时间的精确表现。
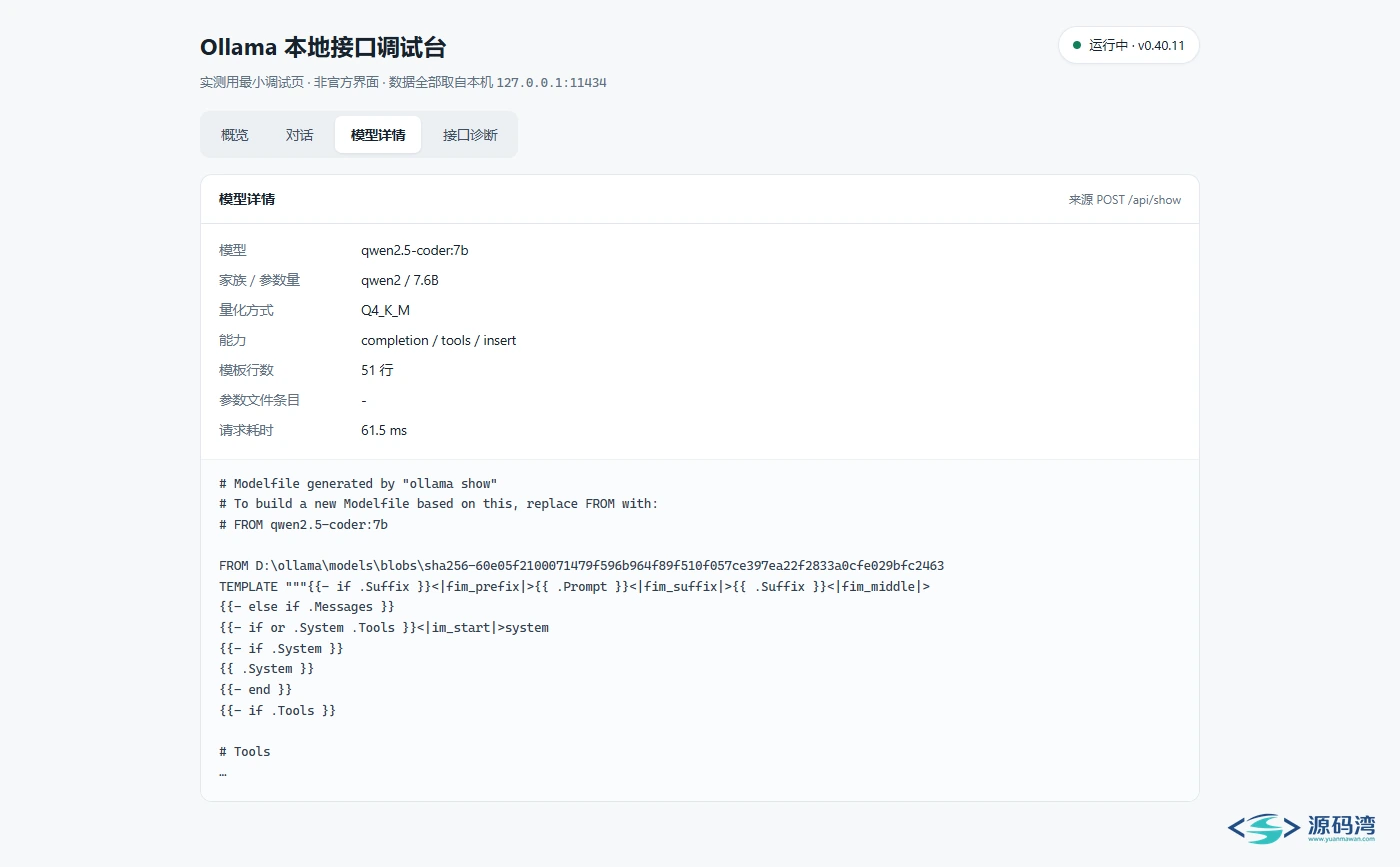
上图为模型信息接口所返回的模型家族归属、量化规格、上下文窗口尺寸及模板结构,展示了底层的参数配置细节。
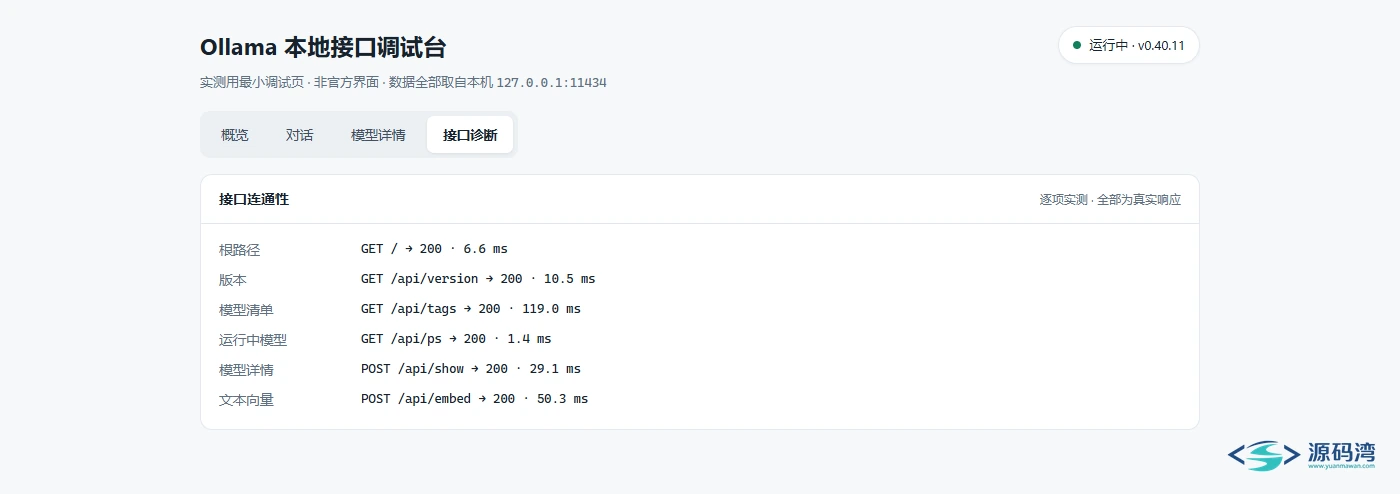
上图为针对根路径、版本接口、标签列表、进程状态及向量接口进行的逐项连通性检查,各项接口均以极低延迟返回 200 状态码。
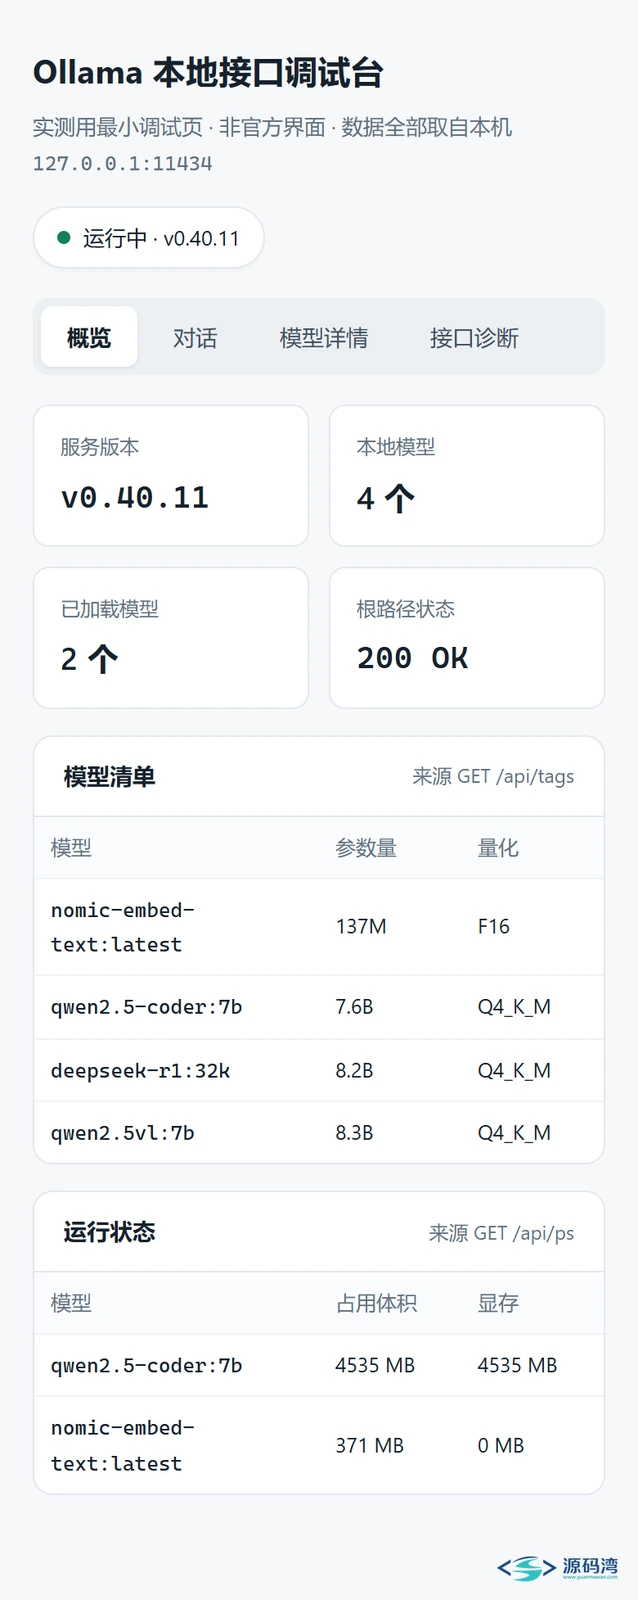
上图为在移动视口环境下的界面布局展示,验证了调试面板在不同设备分辨率下的信息展示兼容性。
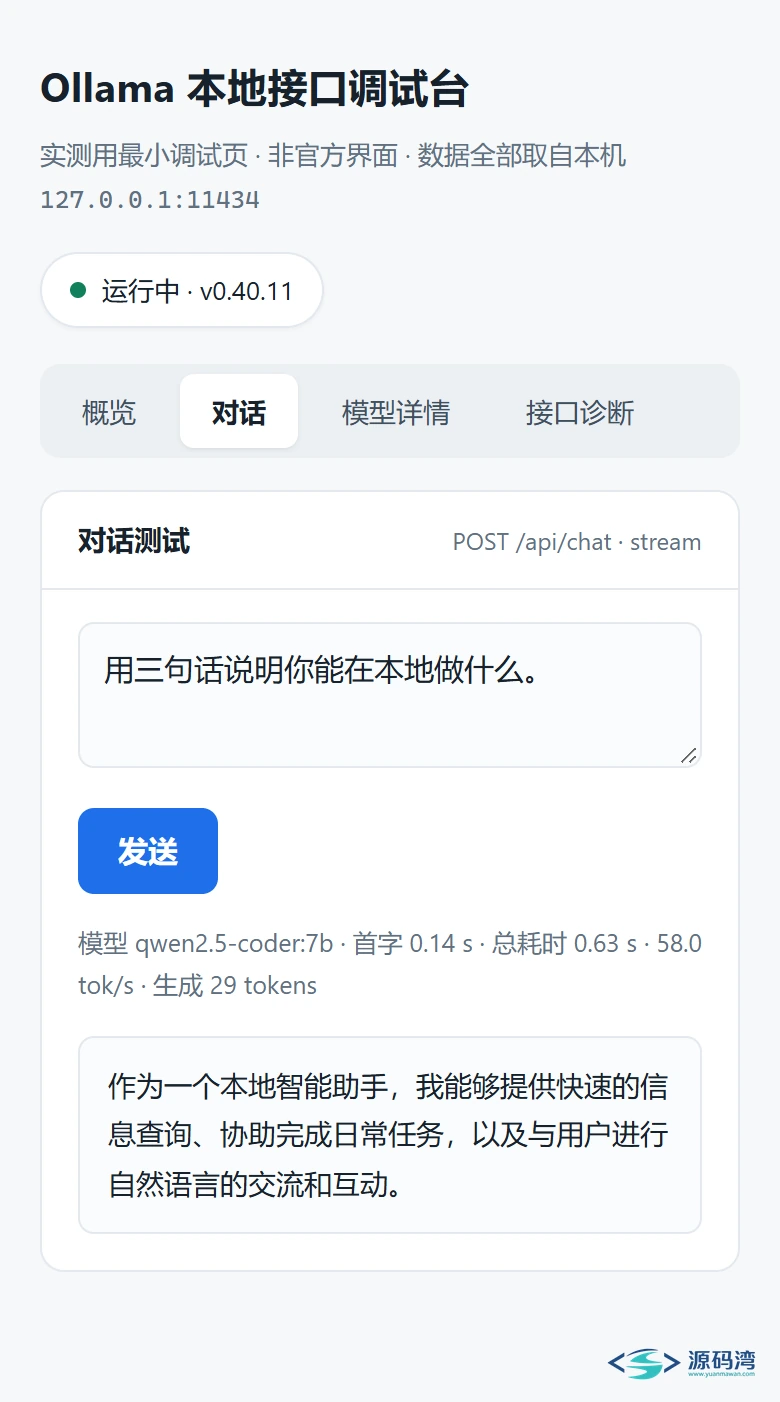
上图为移动视口下的交互实测,显示在窄屏环境下流式生成的速率依然能够保持在 58.0 tok/s 的稳定水平。
一个真实的坑
在本次实测过程中,我们记录了两个极具参考价值的真实踩坑细节:
第一个细节发生在显存调度机制上。在 8GB 显存设备上,如果显存中已经驻留了 7B 参数量的对话模型,此时若调用向量接口提取文本特征,系统默认依然会尝试将嵌入模型载入 GPU 运算。由于显存空间极度逼近上限,GPU 驱动不得不频繁在独立显存与系统内存之间交换数据,导致单次向量计算耗时飙升至 62.5 秒。然而,如果我们在请求参数中显式指定参数强制走纯 CPU 运算,仅需 8.8 秒即可完成计算,耗时反而降低了 85%。因此在显存紧张的多模型混合调用场景下,合理为轻量模型指定运算后端能显著避免显存抖动。
第二个细节发生在服务器选型上。我们曾尝试在一台 2 核 1.6GB 内存的小型云服务器上执行验证,但此类轻量级服务器在处理数吉字节的压缩包解压缩与模型运行时,CPU 与 I/O 资源瞬间被打满,甚至引发管理面板网络断连。这表明此类本地推理框架本质上是重型算力工具,不应当尝试部署在低配云主机上。
线上部署与跨平台差异
如果计划将本地大模型服务作为长期稳定的接口提供给局域网或其它后端使用,有以下几项配置值得关注:
- 服务守护进程化:在 Linux 系统中,建议将服务编写为 systemd 服务单元或通过守护进程工具进行后台托管,确保服务器重启后自动恢复服务状态。
- 跨域与监听地址绑定:默认情况下,服务仅监听本地回环地址(127.0.0.1)。如果需要允许局域网内的其它设备访问,启动时需通过环境变量配置监听所有网络接口,并根据需要配置跨域请求许可。
- 端口防护与权限管理:框架本身不包含用户鉴权体系,所有能访问端口的请求均可自由调用大模型。如果服务需要接入外部网络,务必在外层配置反向代理服务器(如 Nginx),并添加 HTTP 基本鉴权或访问令牌限制。
- 包体与后端的结构差异:Windows 平台的压缩包体积较大,原因在于其完整集成了适配 NVIDIA 显卡与通用架构的多套动态库;而 Linux 平台则依赖系统环境中的底层驱动支持,因而发行体积更为轻巧。
这几类人适合,这几类不适合
适合:
- 需要在本地开发环境或局域网搭建私有化大模型接口的工程师。
- 希望免去环境搭建烦恼、快速在本地验证各类型量化模型的开发者。
- 正在自建本地知识库检索、文本分类或向量检索系统的团队。
- 对数据隐私要求严格、所有提示词与业务文本必须留在本地处理的场景。
不适合:
- 本地硬件配置较低(显存低于 6GB 且处理器较弱),却期望流畅运行 14B 以上大参数模型的用户。
- 期望拥有高度定制化的全图形化聊天界面、不愿接触任何命令行或接口参数的初级用户。
- 试图将大模型部署在 1GB 或 2GB 内存极小云服务器上的场景,这类机器无法承载大模型的内存消耗。
常见问题
{collapse-item label="电脑没有独立显卡是否能够正常运行大模型?"}A:可以运行。框架内置了针对多种 CPU 指令集的优化后端,在纯 CPU 环境下同样能够完成模型推理,但生成速度会明显慢于具备独立显卡加速的环境。在纯 CPU 机器上建议优先运行参数量较小的模型。{/collapse-item}
{collapse-item label="为什么有时首次发起对话时会等待较长时间?"}A:首次发起对话时,服务需要将存放在硬盘上的模型权重文件读取并写入物理显存或内存,这个过程被称为冷启动加载。根据模型体积与硬盘读写速度的不同,加载可能需要数秒到二十秒不等,模型常驻显存后后续对话将恢复高速响应。{/collapse-item}
{collapse-item label="本地下载的模型权重存放在什么路径,如何更改?"}A:默认存放在当前用户的主目录对应隐藏文件夹下。如果系统盘存储空间较小,可以在启动服务前通过设置环境变量指向其它剩余容量较大的磁盘分区。{/collapse-item}
{collapse-item label="在局域网内其它设备无法访问本地搭建的服务是怎么回事?"}A:服务默认仅监听本地 127.0.0.1 端口。若需跨设备访问,需要在启动前设置环境变量绑定全部网络地址,并同时检查本地防火墙是否已放行对应的端口通信规则。{/collapse-item}
源码获取
建议先将资源转存到自己的网盘再行下载,避免大文件直接拉取容易出现网络中断。移动端打开链接可直接保存到网盘,后续在桌面客户端内高速同步。